TL;DR — 용도별 최적의 방법 10초 요약표
- 지금 즉시 변환하고 싶고 설치가 번거로울 때 → FormatArc CSV to JSON (브라우저 완결, 파일 업로드 불필요, UTF-8·따옴표·셀 안 줄바꿈 완벽 지원)
- 쉘 스크립트나 터미널 원라이너가 필요할 때 →
csvjson data.csv(csvkit) 또는mlr --icsv --ojson cat data.csv(Miller) - Python 애플리케이션 내부에서 처리할 때 →
csv.DictReader(표준 라이브러리, 외부 의존성 없음) 또는 대용량 파일은pandas.read_csv - Node.js 애플리케이션 내부에서 처리할 때 → PapaParse의
{ header: true, dynamicTyping: true } - Go 마이크로서비스 내부에서 처리할 때 →
encoding/csv+ 헤더→맵 변환 루프 - 메모리에 전부 올라가지 않는 대용량 파일일 때 →
csv.DictReader로 행마다 NDJSON 스트리밍 출력 (json.dump로 전체 리스트 일괄 출력 금지)
| 방법 | 설치 및 설정 | 대용량 파일 대응 | 타입 추론 | NDJSON 출력 |
|---|---|---|---|---|
| FormatArc 브라우저 | 없음 | 제한적 (전체 메모리 로드, 브라우저 가용 탭 메모리에 좌우) | 없음 (모두 문자열로 안전 보존) | 없음 (CLI 도구 권장) |
Python csv.DictReader | 표준 라이브러리 | 가능 (스트리밍 루프) | 없음 (모두 문자열) | 가능 |
pandas read_csv | pip install pandas | chunksize=로 청크 분할 스트리밍 | 가능 (dtype 자동 추론) | 가능 (lines=True) |
Miller (mlr) | brew install miller | 가능 (완전한 스트리밍 처리) | 가능 (--inumeric) | 가능 (--ojsonl) |
csvkit (csvjson) | pip install csvkit | 제한적 (전체 메모리 로드) | 기본 지원 (--no-inference로 비활성화) | 가능 (--stream) |
| PapaParse (Node.js) | npm install papaparse | 가능 (step 콜백 스트리밍) | 가능 (dynamicTyping) | 가능 (수동 스트림) |
Go encoding/csv | 표준 라이브러리 | 가능 (Read() 루프 스트리밍) | 없음 (수동 파싱) | 가능 (수동 작성) |
이 글에서는 각 변환 방법을 실제 동작하는 코드와 함께 살펴보고, 실무에서 자주 발생하는 4가지 주요 문제(출력 형태, 인코딩 불일치, 타입 추론의 함정, 대용량 파일 성능 최적화)를 구체적인 사례로 설명합니다.
CSV 형식의 기본과 특성 (RFC 4180)
CSV(Comma-Separated Values)는 RFC 4180새 탭에서 열립니다에서 비공식적으로 규정된 텍스트 기반 표 형식입니다. 하지만 실무에서는 다양한 변형과 방언이 존재합니다. 전형적인 CSV의 모습은 다음과 같습니다.
name,email,department,start_date
Alice Johnson,alice@example.com,Engineering,2024-01-15
Bob Smith,bob@example.com,Marketing,2023-06-01
Carol Williams,carol@example.com,Engineering,2024-03-10
1행은 헤더(열 이름)이며, 2행부터 각 데이터 레코드가 이어집니다. 필드는 쉼표(콤마)로 구분되지만, 단순해 보이는 외형과 달리 몇 가지 주의할 점이 있습니다.
- 쉼표가 포함된 필드는 반드시 큰따옴표로 감싸야 합니다:
"Smith, John" - 큰따옴표가 포함된 필드는 큰따옴표를 2개 연속으로 적어 이스케이프합니다:
"She said ""hello""" - 큰따옴표 안의 줄바꿈은 유효합니다 (단순 파서가 가장 흔히 깨지는 원인)
- 인코딩에 단일 표준이 없습니다. UTF-8, UTF-8 BOM, EUC-KR/CP949, Shift-JIS, Latin-1 등 생성 환경에 따라 달라집니다 (Windows 엑셀은 기본적으로 BOM이 붙은 UTF-8이나 CP949로 출력)
- 구분 기호 역시 통일되어 있지 않습니다. TSV는 탭(
\t), 유럽 로케일 엑셀은 세미콜론(;), 일부 데이터셋은 파이프(|)를 사용합니다
CSV의 역사와 세부 규격에 대한 자세한 내용은 CSV 파일이란?을 참고하세요.
왜 CSV를 JSON으로 변환하는가
실무에서 CSV 데이터를 JSON으로 변환해야 하는 대표적인 이유는 다음과 같습니다.
- REST API 통신: 대부분의 최신 웹 API는 요청 본문(Request Body)에 JSON을 요구합니다. 스프레드시트로 관리하던 데이터를 API로 전송(POST)하려면 JSON 구조로 변환해야 합니다.
- 프론트엔드 프레임워크 연동: React, Vue, Svelte, Next.js 등은 JSON 객체와 배열을 네이티브하게 다룹니다. 브라우저에서 CSV를 직접 파싱할 수도 있지만 불필요한 번들 크기와 파싱 오버헤드가 늘어납니다.
- 데이터 타입 보존: CSV는 모든 필드가 문자열(text)입니다. 반면 JSON은 숫자(number), 불리언(boolean), 문자열(string), null을 명확히 구분할 수 있습니다.
- NoSQL 데이터베이스 임포트: MongoDB(
mongoimport), CouchDB, DynamoDB의 벌크 로더는 JSON Lines(NDJSON) 형식을 직접 수집합니다. - 데이터 파이프라인 및 워크플로: Apache Airflow, Prefect, Mage, dbt 같은 데이터 처리 도구는 단계 간 데이터 교환 포맷으로 JSON/NDJSON을 표준으로 요구하는 경우가 많습니다.
- LLM 컨텍스트 전달: 표 형식 데이터를 거대 언어 모델(LLM)에 전달할 때, 단순 CSV보다 명확한 키-값 구조를 가진 JSON 객체가 모델의 필드 인식 정확도를 높이고 환각(hallucination)을 줄이는 데 유리합니다. 자세한 내용은 LLM 입력엔 Markdown vs HTML?을 참고하세요.
두 형식의 차이점과 데이터 모델에 대한 자세한 내용은 JSON이란 무엇인가에서 다룹니다.
5가지 JSON 출력 형태
대부분의 CSV-JSON 변환 도구는 "헤더를 키로 갖는 객체 배열" 한 가지만 제공합니다. 하지만 데이터가 소비되는 환경에 따라 필요한 구조는 달라집니다. 동일한 CSV가 어떻게 5가지 서로 다른 JSON 형태로 변환되는지 비교해 봅니다.
입력 CSV:
id,name,score
1,Alice,95
2,Bob,87
3,Carol,92
출력 형태는 변환 도구의 기본값이 아니라, 이 데이터를 받아 처리할 시스템의 요구사항에 맞춰 선택해야 합니다.
| 형태 | JSON 구조 | 선택 기준 | 생성 방법 |
|---|---|---|---|
| 객체 배열 | [{...}, {...}] | REST API나 프론트엔드 컴포넌트가 행 목록을 순차적으로 받을 때 | 대부분의 변환 도구 기본값 |
| Keyed 객체 | {"id": {...}} | 반복 순회 없이 특정 ID로 직접 조회(Lookup)하고 싶을 때 | Python 딕셔너리 컴프리헨션 |
| JSON Lines (NDJSON) | 1행 1객체 (배열 감싸기 없음) | 파일이 너무 커서 메모리에 다 담을 수 없거나 데이터 웨어하우스가 읽을 때 | 대용량 파일은 mlr --ojsonl, 메모리에 이미 배열이 있다면 jq -c '.[]' |
| 열 지향 (Columnar) | {"col": [v1, v2]} | 수신 측 Python/데이터 분석 코드가 열별 리스트를 기대할 때 | pandas df.to_dict(orient="list") |
| 중첩 구조 (Nested) | [{"a": {"b": v}}] | API 요청 본문이 계층적 객체 구조를 요구할 때 | 슬래시(/) 구분 헤더 + 후처리 |
형태 1: 객체 배열 (대부분 도구의 기본값)
[
  { "id": 1, "name": "Alice", "score": 95 },
  { "id": 2, "name": "Bob", "score": 87 },
  { "id": 3, "name": "Carol", "score": 92 }
]
용도: REST API 요청, 프론트엔드 데이터 렌더링, 범용 데이터 교환.
형태 2: Keyed 객체 (특정 열을 기본 키로 사용)
{
  "1": { "name": "Alice", "score": 95 },
  "2": { "name": "Bob", "score": 87 },
  "3": { "name": "Carol", "score": 92 }
}
용도: 룩업 테이블, ID 기반 O(1) 딕셔너리 접근. Python으로 생성하는 방법:
import csv, json, sys
rows = list(csv.DictReader(sys.stdin))
result = {row["id"]: {k: v for k, v in row.items() if k != "id"} for row in rows}
json.dump(result, sys.stdout, indent=2, ensure_ascii=False)
형태 3: JSON Lines / NDJSON (줄바꿈 구분 JSON)
{"id":1,"name":"Alice","score":95}
{"id":2,"name":"Bob","score":87}
{"id":3,"name":"Carol","score":92}
용도: 대용량 스트리밍 수집(BigQuery, Snowflake COPY INTO, MongoDB mongoimport --type=json, 로그 수집 파이프라인, Kafka 프로듀서). 1행이 완전한 독립 JSON 객체이므로 10GB 이상의 파일도 메모리 부담 없이 한 줄씩 순차 처리할 수 있습니다.
생성 방법: Miller의 mlr --icsv --ojsonl cat data.csv 또는 jq -c '.[]' array.json > lines.ndjson.
형태 4: 열 지향 (병렬 배열)
{
  "id": [1, 2, 3],
  "name": ["Alice", "Bob", "Carol"],
  "score": [95, 87, 92]
}
용도: 데이터 과학 및 머신러닝(Apache Arrow / pandas 내부 메모리 레이아웃과 일치), GPU 가속 파이프라인, 컬럼형 데이터베이스. pandas로 생성: df.to_dict(orient="list").
형태 5: 슬래시 구분 헤더로 중첩 구조 생성
입력 CSV (헤더에 슬래시 구분자 사용):
id,name,address/city,address/zip
1,Alice,Seoul,04524
2,Bob,Busan,48058
출력 (중첩 JSON):
[
  { "id": 1, "name": "Alice", "address": { "city": "Seoul", "zip": "04524" } },
  { "id": 2, "name": "Bob",   "address": { "city": "Busan", "zip": "48058" } }
]
용도: 계층 구조를 요구하는 API 페이로드 생성. 대부분의 변환 도구는 추가 후처리가 필요합니다.
방법 1: FormatArc 브라우저 도구 (업로드 불필요)
별도 도구 설치 없이 지금 즉시 CSV를 JSON으로 변환하고 싶다면 FormatArc CSV to JSON이 가장 빠릅니다. 모든 연산이 브라우저 내부에서 실행되므로 데이터가 외부 서버로 전송되지 않습니다.
- CSV to JSON 변환기를 엽니다.
- 왼쪽 에디터에 CSV 텍스트를 붙여넣습니다.
- 변환 버튼을 누르면 오른쪽에 정리된 JSON 결과가 나타납니다.
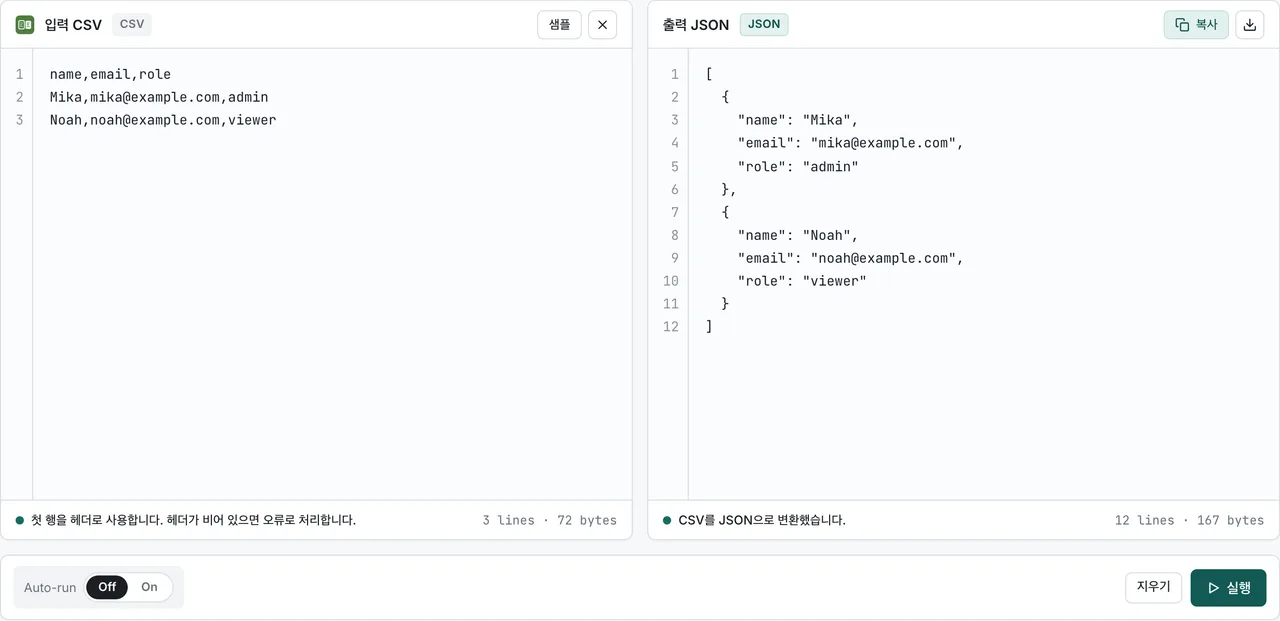
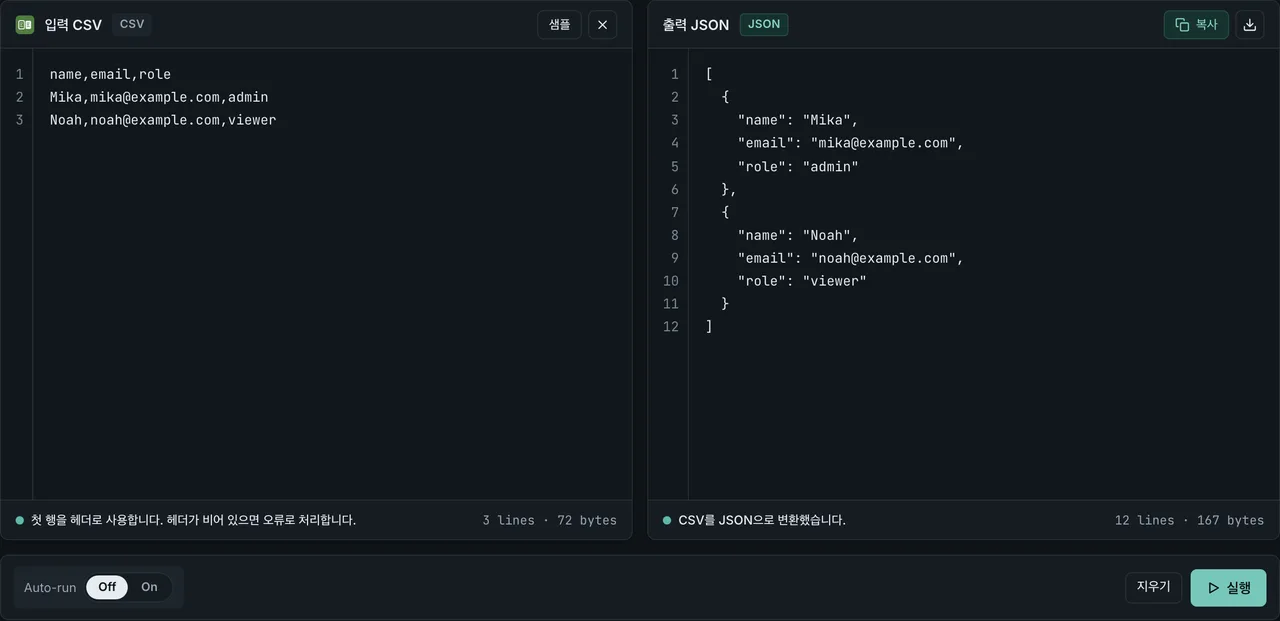
일반적인 파서에서 오류가 나기 쉬운 엣지 케이스도 브라우저 안에서 안전하게 처리합니다. 큰따옴표로 감싸진 필드 내부의 쉼표, 줄바꿈이 포함된 셀, 빈 필드(빈 문자열로 변환) 등을 올바르게 다룹니다.
브라우저 완결형 처리는 민감한 보안 데이터를 다룰 때 특히 중요합니다. 고객 정보, 급여 데이터, 보안 저장소에서 내보낸 API 키, 사내 재무 지표 등을 다룰 때도 외부 업로드 없이 현재 브라우저 탭 안에서만 안전하게 변환할 수 있습니다.
방법 2: Python — csv.DictReader와 pandas
Python은 표준 라이브러리에 csv와 json 모듈을 내장하고 있어 외부 패키지 설치 없이도 바로 변환할 수 있습니다.
import csv
import json
import sys

reader = csv.DictReader(sys.stdin)
rows = list(reader)
json.dump(rows, sys.stdout, indent=2, ensure_ascii=False)
csv2json.py로 저장한 뒤 다음과 같이 실행합니다.
python3 csv2json.py < data.csv > data.json
csv.DictReader는 첫 번째 행을 자동으로 헤더로 인식합니다. 각 행이 dict가 되며, 딕셔너리의 리스트가 JSON의 객체 배열로 직렬화됩니다. 한국어나 일본어, 특수 문자가 포함된 경우 ensure_ascii=False 옵션을 지정해야 유니코드 이스케이프(\ud55c\uae00) 없이 온전한 한글로 출력됩니다.
pandas 사용 (대용량 파일 + 타입 추론)
데이터 분석 환경이나 대용량 파일 처리에는 pandas가 유용합니다.
import pandas as pd

df = pd.read_csv("data.csv", encoding="utf-8")
df.to_json("data.json", orient="records", indent=2, force_ascii=False)
orient="records"는 객체 배열 형태를 만듭니다. 다른 유용한 옵션으로는 "index" (Keyed 객체), "columns" (열 지향), "values" (배열의 배열)가 있습니다.
메모리에 한 번에 담기 어려운 대용량 파일은 chunksize로 청크 분할 스트리밍합니다.
import pandas as pd

with open("output.ndjson", "w", encoding="utf-8") as out:
    for chunk in pd.read_csv("huge.csv", chunksize=10000):
        chunk.to_json(out, orient="records", lines=True, force_ascii=False)
        out.write("\n")
이 코드는 NDJSON 형식으로 출력하며, 메모리에는 항상 10,000행만 유지되므로 일정한 메모리로 대용량 파일을 처리할 수 있습니다.
방법 3: Node.js — PapaParse
JavaScript 및 Node.js 생태계에서 CSV 파싱의 사실상 표준 라이브러리는 papaparse입니다. FormatArc의 브라우저 도구도 내부적으로 PapaParse를 사용합니다.
const Papa = require("papaparse");
const fs = require("fs");

const csv = fs.readFileSync("data.csv", "utf8");
const result = Papa.parse(csv, {
  header: true,
  dynamicTyping: true,   // "42" → 42, "true" → true로 자동 변환
  skipEmptyLines: true,
});

fs.writeFileSync("data.json", JSON.stringify(result.data, null, 2));
기가바이트 단위의 대용량 파일은 Node.js 스트림과 step 콜백을 결합해 메모리 사용량을 최소화합니다.
const fs = require("fs");
const Papa = require("papaparse");

const stream = fs.createReadStream("huge.csv");
const out = fs.createWriteStream("huge.ndjson");

Papa.parse(stream, {
  header: true,
  dynamicTyping: true,
  step: (row) => out.write(JSON.stringify(row.data) + "\n"),
  complete: () => out.end(),
});
각 행이 디스크에 즉시 기록되므로 파일 크기가 아무리 커져도 메모리 사용량은 일정하게 유지됩니다.
방법 4: Go — encoding/csv
Go 표준 라이브러리의 encoding/csv와 encoding/json을 활용한 고성능 변환 예제입니다.
package main

import (
    "encoding/csv"
    "encoding/json"
    "fmt"
    "os"
)

func main() {
    f, err := os.Open("data.csv")
    if err != nil {
        panic(err)
    }
    defer f.Close()

    reader := csv.NewReader(f)
    records, err := reader.ReadAll()
    if err != nil {
        panic(err)
    }

    headers := records[0]
    result := make([]map[string]string, 0, len(records)-1)
    for _, row := range records[1:] {
        obj := make(map[string]string, len(headers))
        for i, val := range row {
            obj[headers[i]] = val
        }
        result = append(result, obj)
    }

    out, _ := json.MarshalIndent(result, "", "  ")
    fmt.Println(string(out))
}
Go의 encoding/csv는 기본적으로 모든 필드를 문자열로 취급합니다. 숫자나 불리언 타입으로 변환하고 싶다면 strconv.Atoi, strconv.ParseFloat, strconv.ParseBool을 수동으로 호출해야 합니다.
대용량 파일을 다룰 때는 ReadAll() 대신 for 루프에서 Read()를 호출해 한 행씩 읽고 json.Marshal로 NDJSON 파일에 기록하면 메모리 소비를 일정하게 제어할 수 있습니다.
방법 5: Miller와 csvkit (원라이너 CLI)
터미널이나 쉘 스크립트에서 단 한 줄의 명령어로 변환하고 싶을 때는 두 가지 강력한 CLI 도구가 유용합니다.
Miller (mlr)
Miller는 구조화된 데이터를 위한 고성능 스트리밍 프로세서로, CSV/JSON/TSV를 다루는 awk 같은 위치를 차지합니다.
# JSON 객체 배열로 변환
mlr --icsv --ojson cat data.csv > data.json

# NDJSON (스트리밍 파이프라인에 최적)
mlr --icsv --ojsonl cat data.csv > data.ndjson

# 필터링과 변환을 동시에 수행
mlr --icsv --ojson filter '$score > 90' data.csv

# 변환 과정에서 계산된 열 추가
mlr --icsv --ojson put '$grade = $score >= 90 ? "A" : "B"' data.csv
설치: macOS는 brew install miller, Linux(Debian/Ubuntu)는 apt install miller로 설치합니다.
csvkit (csvjson)
csvkit은 Python 기반의 CSV 전문 도구 모음입니다.
pip install csvkit
csvjson data.csv > data.json
주요 옵션:
--indent 2— 들여쓰기가 적용된 보기 좋은 JSON 출력--no-inference— 자동 숫자 변환을 끄고 모든 값을 문자열로 보존--stream— 배열 대신 NDJSON으로 스트리밍 출력--locale ko_KR.UTF-8— 로케일 맞춤 숫자 파싱
코드 작성 없이 터미널에서 빠르게 NDJSON을 뽑아내고 싶을 때 csvjson --stream은 가장 손쉬운 선택입니다.
중첩 JSON 생성 (슬래시 구분 헤더)
대부분의 변환기는 1차원 플랫 객체만 생성합니다. 백엔드 REST API, MongoDB 스키마, GraphQL 리졸버가 중첩된 객체 구조를 요구한다면 후처리 로직이 필요합니다.
실무에서는 헤더에 슬래시(/)나 점(.)을 넣어 계층 구조를 표현하는 관례를 널리 사용합니다.
id,name,address/city,address/zip,address/country
1,Alice,Seoul,04524,KR
2,Bob,Busan,48058,KR
Python으로 중첩 객체를 생성하는 스크립트입니다.
import csv, json, sys

def nest(row, sep="/"):
    result = {}
    for key, val in row.items():
        parts = key.split(sep)
        cursor = result
        for part in parts[:-1]:
            cursor = cursor.setdefault(part, {})
        cursor[parts[-1]] = val
    return result

reader = csv.DictReader(sys.stdin)
rows = [nest(r) for r in reader]
json.dump(rows, sys.stdout, indent=2, ensure_ascii=False)
출력 결과:
[
  { "id": "1", "name": "Alice", "address": { "city": "Seoul", "zip": "04524", "country": "KR" } },
  { "id": "2", "name": "Bob",   "address": { "city": "Busan", "zip": "48058", "country": "KR" } }
]
점 표기법(address.city)을 사용하고 싶다면 sep="."로 변경하면 됩니다.
인코딩 및 구문 문제 해결 (UTF-8 BOM / EUC-KR / 따옴표 / 줄바꿈)
인코딩 불일치는 CSV를 JSON으로 변환할 때 텍스트가 깨지는 가장 흔한 원인입니다.
UTF-8 BOM (Byte Order Mark)
Windows 엑셀에서 "CSV UTF-8" 형식으로 저장하면 파일 맨 앞에 3바이트의 BOM(EF BB BF)이 추가됩니다. 많은 JSON 파서는 BOM을 자동으로 제거하지 않으므로, 첫 번째 필드의 키가 name이 아니라 보이지 않는 문자가 붙은 name으로 변환됩니다.
Python에서 해결:
with open("data.csv", encoding="utf-8-sig") as f:  # -sig 옵션이 BOM을 자동 제거
    reader = csv.DictReader(f)
Miller에서 해결: mlr --icsv --ojson cat <(sed '1s/^\xEF\xBB\xBF//' data.csv).
EUC-KR / CP949 및 Shift-JIS (엑셀 기본 인코딩)
한국어 Windows 엑셀에서 기본 "CSV(쉼표로 분리)"로 저장하면 UTF-8이 아닌 CP949(EUC-KR 확장)로 출력됩니다. 이를 UTF-8로 잘못 읽으면 한글이 `` 형태로 깨집니다. 마찬가지로 일본어 엑셀은 Shift-JIS로 출력됩니다.
Python에서 인코딩 지정:
with open("data.csv", encoding="cp949") as f:  # 한글 깨짐 방지
    reader = csv.DictReader(f)
터미널에서 UTF-8로 일괄 변환:
iconv -f CP949 -t UTF-8 data.csv > data.utf8.csv
FormatArc 브라우저 도구는 UTF-8 입력을 표준으로 지원하므로, CP949/EUC-KR이나 Shift-JIS 파일은 에디터에서 UTF-8로 다시 저장하거나 iconv로 변환한 뒤 붙여넣으세요.
Latin-1 (유럽 엑셀 기본값)
서유럽 로케일의 엑셀은 Latin-1(Windows-1252)로 저장되는 경우가 많습니다. iconv -f LATIN1 -t UTF-8로 변환하거나 Python에서 encoding="latin-1"을 지정합니다.
따옴표 안 쉼표와 셀 안 줄바꿈
구분 기호(쉼표)나 줄바꿈을 포함하는 필드는 반드시 큰따옴표로 감싸야 합니다.
id,description
1,"Hello, world"
2,"Multi-line
description here"
단순히 string.split(",")으로 구현한 파서는 1행의 쉼표에서 필드를 잘못 쪼개고, 2행의 줄바꿈에서 레코드가 끊긴 것으로 오작동합니다. 반드시 규격을 준수하는 정식 CSV 파서(csv.DictReader, PapaParse, Miller, csvkit)를 사용해야 합니다.
쉼표 이외의 구분 기호 (세미콜론 / 탭 / 파이프)
유럽 환경 엑셀은 소수점 기호로 쉼표를 사용하기 때문에 필드 구분자로 세미콜론(;)을 채택합니다. 이때는 구분 기호를 명시적으로 지정해야 합니다.
reader = csv.DictReader(f, delimiter=";")
mlr --csv --ifs ";" --ojson cat data.csv
Papa.parse(csv, { header: true, delimiter: ";" });
TSV(탭 구분 파일)는 delimiter="\t" 또는 Miller의 --itsv 옵션을 사용합니다.
타입 추론 (숫자 / 불리언 / null 해석)
CSV는 본질적으로 모든 값이 텍스트입니다. 이를 JSON으로 바꿀 때 숫자나 불리언으로 자동 변환(타입 추론)할지 여부는 도구마다 다릅니다.
| 도구 | 기본 동작 | 타입 추론 활성화 방법 |
|---|---|---|
Python csv.DictReader | 모두 문자열 | 수동 타입 변환(Casting) |
pandas read_csv | 열 단위 자동 추론 | 기본 활성화 (dtype=str로 비활성화 가능) |
| PapaParse (Node.js) | 모두 문자열 | { dynamicTyping: true } |
Miller (mlr) | 모두 문자열 | --inumeric 플래그 |
csvkit (csvjson) | 자동 추론 활성화 | --no-inference로 비활성화 |
| FormatArc 브라우저 | 모두 문자열 보존 (데이터 왜곡 방지) | - |
자동 타입 추론을 무심코 켰을 때 발생하는 위험 요소:
"007"이 숫자7로 변환되어 앞자리 0이 손실됩니다 (전화번호, 우편번호, 사번, 주민등록번호, ISBN 등에서 치명적)."NaN","Infinity"문자열이 부동소수점 값으로 변환될 수 있습니다."true","false","yes","no"등이 불리언으로 자동 변환됩니다.- 빈 문자열
""이 도구에 따라null,"", 또는 필드 생략으로 제각각 처리됩니다. - 15자리를 초과하는 숫자형 ID가 JavaScript의 배정밀도 부동소수점 한계(
Number.MAX_SAFE_INTEGER = 2^53 - 1, 약 9,007조)로 인해 뒷자리 정밀도가 유실됩니다.
안전한 원칙: 프로덕션 데이터 파이프라인에서는 모든 필드를 문자열로 유지하고, 스키마를 정확히 알고 있는 애플리케이션 계층에서 명시적으로 타입을 변환하는 것이 가장 안전합니다.
성능과 대용량 파일 처리
수 메가바이트 이내의 작은 파일이라면 어떤 방법을 써도 속도 차이를 체감하기 어렵습니다. 하지만 데이터가 메모리 한계를 넘어서기 시작하면 도구 선택이 처리 속도와 안정성을 좌우합니다.
| 파일 크기 | 권장 방법 | 선택 이유 |
|---|---|---|
| 메모리에 여유 있게 들어가는 크기 | FormatArc 브라우저 도구 / csvkit / pandas | 스트리밍 구현 불필요, 빠른 즉시 처리 |
| 한 번에 로드하기에 부담스러운 대용량 | pandas chunksize / Miller / PapaParse stream / Go | 1행 또는 청크 단위 처리로 메모리 초과(OOM) 방지 |
| 매우 큰 대용량 파일 (수 GB 이상) | Miller / Go encoding/csv / Python csv.DictReader + NDJSON | 고정된 메모리 점유율을 유지하는 순수 스트리밍 필수 |
스루풋 실측 데이터 (Apple M5 Pro / 64GB RAM / macOS 26.5, 5개 열 1,000,000행 CSV, 단일 스레드, 재현 스크립트는 저장소의 scripts/benchmarks/csv-to-json-throughput/ 참조):
- Python
csv.DictReader+json.dump(Python 3.14.6): 약 232,000 행/초 - pandas
read_csv+to_json(pandas 3.0.3): 약 1,113,000 행/초 - Miller
mlr --c2j(Miller 6.19.0): 약 1,960,000 행/초 (5회 측정 웜 중앙값. 콜드 초회는 FS 캐시 미스로 약 990,000 행/초) - Go
encoding/csv+encoding/json(Go 1.26.4): 약 2,058,000 행/초 - PapaParse streaming (papaparse 5.5.2 / Node 26.3.1): 약 1,626,000 행/초
- FormatArc 브라우저 도구: 내부적으로 PapaParse 5.5 엔진을 사용하지만, 브라우저 메인 스레드 응답성과 탭 메모리 제한에 좌우되므로 CLI 수준의 처리량은 나오지 않습니다. 실무에서는 수십 MB, 수십만 행 규모가 부드럽게 동작하는 실용적인 범위입니다.
측정 수치는 하드웨어, OS, 런타임 버전에 따라 달라집니다. 구형 CPU나 구버전 라이브러리(pandas 2.x, Miller 5.x 등)에서는 현저히 낮은 처리량을 보일 수 있으므로 중요한 시스템에서는 자체 환경에서 재측정해 보는 것이 좋습니다.
테라바이트(TB) 단위의 빅데이터는 일반 단일 머신 도구 대신 DuckDB(COPY data FROM 'data.csv' (FORMAT CSV) → COPY (SELECT * FROM data) TO 'out.ndjson' (FORMAT JSON, ARRAY false)), Apache Spark, Apache Arrow를 사용하는 것이 적합합니다.
임의 크기 파일을 위한 스트리밍 패턴 (Python)
import csv
import json
import sys

writer = sys.stdout
reader = csv.DictReader(open("huge.csv", encoding="utf-8"))
for row in reader:
    writer.write(json.dumps(row, ensure_ascii=False) + "\n")
이 코드는 NDJSON 형식으로 한 줄씩 즉시 출력합니다. 입력 파일 크기가 아무리 커도 1행분의 메모리만 소비하므로 메모리 사용량이 일정합니다. 파이프를 통해 gzip -c > out.ndjson.gz로 실시간 압축하거나 BigQuery, AWS S3 등으로 곧바로 스트리밍 전송할 수 있습니다.
CI/CD 워크플로 (curl POST와 GitHub Actions)
Git 저장소에서 관리되는 CSV 파일을 푸시할 때마다 JSON으로 변환하여 REST API로 전송하는 자동화 파이프라인 예시입니다.
# 변환 수행
python3 csv2json.py < users.csv > users.json

# API로 전송
curl -X POST https://api.example.com/users/bulk \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $API_TOKEN" \
  -d @users.json
GitHub Actions 워크플로 구성:
name: Sync user CSV to API
on:
  push:
    paths: ["data/users.csv"]

jobs:
  sync:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Install Miller
        run: sudo apt-get install -y miller
      - name: Convert and upload
        env:
          API_TOKEN: ${{ secrets.API_TOKEN }}
        run: |
          mlr --icsv --ojson cat data/users.csv > users.json
          curl -fsS -X POST https://api.example.com/users/bulk \
            -H "Content-Type: application/json" \
            -H "Authorization: Bearer $API_TOKEN" \
            -d @users.json
일회성 API 테스트 목적이라면 CSV를 CSV to JSON 변환기에 붙여넣은 뒤 생성된 JSON을 복사하여 Postman, Insomnia, curl에 전달하는 것만으로 충분합니다.
변환된 JSON을 깔끔하게 정리하여 전송하고 싶다면 JSON 정렬 방법을 참고하세요. curl 응답을 터미널에서 정렬하는 방법은 curl JSON 정렬 방법에서 다룹니다.
자주 묻는 질문
엑셀에서 내보낸 CSV의 BOM을 FormatArc에서 처리할 수 있나요?
네. FormatArc 브라우저 도구는 입력된 UTF-8 텍스트에서 BOM을 자동으로 감지하고 제거합니다. Python에서는 encoding="utf-8-sig"를 사용하고, Node.js의 PapaParse 역시 BOM을 투명하게 처리합니다.
NDJSON(JSON Lines)으로 출력할 수 있나요?
현재 FormatArc 브라우저 도구는 표준 JSON 객체 배열을 출력합니다. NDJSON 출력이 필요하다면 Miller(mlr --icsv --ojsonl) 또는 csvkit(csvjson --stream)을 사용하세요. 로그 파이프라인이나 데이터베이스 벌크 수집에서는 이 형식이 표준입니다.
헤더가 없는 CSV를 변환하려면 어떻게 하나요?
Python csv.DictReader의 경우 fieldnames 인수에 열 이름을 직접 전달합니다.
reader = csv.DictReader(f, fieldnames=["id", "name", "score"])
PapaParse는 Papa.parse(csv, { header: false })를 통해 2차원 배열(배열의 배열)로 읽어 들인 뒤 수동으로 객체로 매핑합니다.
숫자 ID 열이 문자열로 출력됩니다
대부분의 도구는 데이터 왜곡을 막기 위해 기본적으로 모든 필드를 문자열로 출력합니다. 숫자로 출력하려면 타입 추론 옵션을 활성화하세요 (PapaParse의 dynamicTyping: true, Miller의 --inumeric, pandas의 dtype). 단, 15자리를 초과하는 ID는 자바스크립트 부동소수점 정밀도 한계로 뒷자리가 잘릴 수 있다는 점에 유의하세요.
JSON 키 시작 부분에  문자가 보입니다
이는 UTF-8 BOM 바이트(EF BB BF)가 Latin-1 인코딩으로 잘못 해석되어 화면에 표시된 상태입니다. Python에서 파일을 읽을 때 encoding="utf-8-sig"를 지정하거나 sed '1s/^\xEF\xBB\xBF//' data.csv로 BOM을 미리 제거하세요.
브라우저에서 변환할 수 있는 최대 CSV 크기는 얼마인가요?
고정된 상한선은 없으며 사용 중인 기기의 브라우저 탭 가용 메모리에 따라 결정됩니다. 브라우저는 원본 텍스트와 파싱된 JSON 객체를 모두 메모리에 유지하므로 실제 파일 크기보다 많은 메모리를 사용합니다. 기가바이트 단위의 대용량 파일은 Miller, pandas chunksize, Go 스트리밍 프로그램을 사용하는 것을 권장합니다.
셀 안에 JSON 문자열이 들어 있는 CSV를 변환하려면 어떻게 하나요?
CSV 셀 내부에 "{""key"":""value""}" 같은 JSON 문자열이 들어 있다면, 먼저 일반 텍스트로 파싱한 뒤 해당 필드에 json.loads()를 적용합니다.
import pandas as pd, json
df = pd.read_csv("data.csv")
df["metadata"] = df["metadata"].apply(json.loads)
df.to_json("data.json", orient="records", force_ascii=False)
JSON 출력에서도 열 순서를 유지할 수 있나요?
최신 도구들은 모두 열 순서를 보존합니다. Python 3.7 이상의 dict는 삽입 순서를 유지하며, csv.DictReader는 헤더 순서를 따르고, pandas의 to_json(orient="records") 역시 열 순서를 그대로 유지합니다. Python의 json.dump는 sort_keys=True를 명시적으로 전달하지 않는 한 키를 임의로 재정렬하지 않습니다.
관련 도구
- CSV to JSON 변환기 — 브라우저 안에서 서버 전송 없이 즉시 CSV를 JSON으로 변환
- JSON to YAML 변환기 — 생성된 JSON을 Kubernetes, Docker Compose, OpenAPI 명세용 YAML로 변환
- JSON 포맷터 — JSON 데이터의 들여쓰기 정렬 및 문법 오류 자동 검증
- CSV to Markdown 변환기 — 스프레드시트나 CSV 데이터를 GitHub 호환 마크다운 표로 변환
정리
CSV를 JSON으로 변환할 때는 작업 환경과 데이터 규모에 맞는 방법을 선택하는 것이 효율적입니다.
- 설치 없는 즉시 변환 및 보안 데이터: FormatArc CSV to JSON — 브라우저 완결형, 서버 업로드 없음, 특수 문자 및 인코딩 이슈 대응
- 쉘 스크립트 및 CLI 자동화: Miller (
mlr --icsv --ojson) 또는 csvkit (csvjson) - Python 애플리케이션: 표준 라이브러리
csv.DictReader, 대용량 및 분석 작업에는 pandas - Node.js 애플리케이션: PapaParse (
dynamicTyping및 대용량용step스트리밍) - Go 마이크로서비스:
encoding/csv와 행 단위 스트리밍 루프
성공적인 변환을 위한 4가지 핵심 포인트: 목적에 맞는 출력 형태(배열 / NDJSON / Keyed / 열 지향 / 중첩) 선택, 소스 파일의 인코딩(UTF-8 BOM, EUC-KR/CP949, Shift-JIS) 확인, 타입 추론 적용 여부 결정, 메모리를 초과하는 대용량 파일의 스트리밍 처리 적용을 기억하세요. CSV 데이터를 마크다운 표로 변환하고 싶다면 CSV to Markdown 변환 가이드를, 생성된 JSON을 Kubernetes나 Docker Compose용 설정으로 변환하는 다음 단계는 JSON YAML 변환 가이드를 참고하세요.