웹 페이지의 HTML 소스를 복사해 ChatGPT, Claude, Gemini 같은 LLM(대규모 언어 모델)에 붙여넣으면 본문 이외의 태그나 속성도 입력에 포함됩니다. 본문 요약이나 추출이 목적이라면 이러한 요소가 토큰을 소비하고 처리 대상을 알아보기 어렵게 만들 수 있습니다. 복사한 HTML에는 div 래퍼 태그, 긴 class 속성, 인라인 스크립트, 추적용 픽셀 등 모델이 본문을 이해하는 데 전혀 필요 없는 마크업이 대량으로 섞여 있습니다. 마크다운(Markdown)으로 변환하면 불필요한 태그와 속성을 제거하고, 제목이나 목록 같은 구조를 유지하면서 본문 중심의 입력으로 정리할 수 있습니다.
이 글에서는 LLM 프롬프트 입력 형식으로서 마크다운과 HTML을 비교하고, OpenAI tiktoken 기반 자체 실측 데이터와 공개 벤치마크를 통해 구체적인 차이를 보여 드립니다. 아울러 HTML을 유지해야 하는 예외적인 상황과 사내 기밀 문서를 외부 서버 전송 없이 브라우저 내에서 안전하게 마크다운으로 변환하는 실무 절차를 소개합니다.
결론부터
LLM 프롬프트에 문서를 입력할 때는 마크다운(Markdown)을 우선 선택하세요. 이번 샘플에서 마크다운의 토큰 수는 HTML의 약 30%였습니다(832 → 243). 절감 폭은 원본 HTML에 포함된 태그나 속성의 양에 따라 달라집니다. 외부 평가에서는 표 추출 정확도에서 마크다운이 HTML을 앞선 사례도 소개되어 있습니다.
변환 절차도 간단합니다. 변환하려는 HTML을 HTML to Markdown 변환기에 붙여넣고 변환된 마크다운을 프롬프트에 복사하기만 하면 됩니다. 변환 처리는 브라우저 안에서 자바스크립트로 완결되므로 붙여넣은 HTML이 FormatArc 서버나 제3자 서비스로 전송되지 않습니다.
LLM은 포맷을 어떻게 읽을까
LLM은 브라우저처럼 렌더링된 웹 화면을 "보고" 있는 것이 아닙니다. 원시 텍스트 소스를 토큰(Token) 스트림으로 변환해 처리합니다. 꺾쇠괄호(< >), 클래스명, 인라인 스타일 등 모든 문자가 실제 본문 콘텐츠를 채워야 할 컨텍스트 윈도우(Context Window)의 용량을 잠식합니다.
여기서 두 가지 문제가 발생합니다.
- 래퍼 요소가 많은 HTML을 전달하면 지시문, 예시(Few-shot), 모델의 답변을 담을 수 있는 공간이 줄어듭니다.
class="text-base text-gray-700"이나data-*속성, 분석 태그 같은 마크업 잡음으로 인해 모델이 요약하거나 추출해야 할 실제 본문을 놓치는 원인이 됩니다.
마크다운은 동일한 구조(제목, 목록, 링크, 코드)를 여닫는 태그 대신 1~2글자의 기호로 간결하게 표현합니다. 그 결과 길이가 대폭 줄어들 뿐 아니라, LLM이 사전 학습 데이터에서 가장 흔하게 접해 온 패턴과 가까워집니다. GitHub의 README, 기술 문서 사이트, Stack Overflow의 게시글, 개발자 포럼 스레드 등 공개된 기술 문서의 상당수가 마크다운으로 작성되어 있기 때문입니다.
마크다운이 구조적으로 가벼운 이유는 태그 모델 자체에 있습니다. 웹 페이지나 CMS에서 실제로 복사하는 HTML(직렬화된 DOM)에서는 대부분의 컨테이너 요소가 시작 태그와 종료 태그의 쌍(<p>...</p>, <li>...</li>, <td>...</td>, <div>...</div>)으로 전달됩니다. 마크업 비용이 요소마다 두 번(열기 1회, 닫기 1회)씩 청구되는 셈입니다(HTML 사양상 일부 종료 태그를 생략할 수 있지만, 렌더링된 DOM 직렬화나 템플릿 엔진은 결국 이를 모두 출력하므로 복사하는 형태는 태그 쌍입니다). 중첩 구조에서는 이 비용이 배로 늘어납니다. 테이블 셀 안의 목록 항목은 들어갈 때 시작 태그를, 나올 때 종료 태그를 겹겹이 쌓으며, 각 태그에 class, id, style, data-* 속성이 붙어 모델에게 불필요한 문자 수만 증가시킵니다.
반면 마크다운은 동일한 구조를 한 번만 배치하는 단일 마커로 표현합니다. 제목은 #, 목록 항목은 -, 표의 열 구분은 |, 문단 구분은 빈 줄 하나로 끝납니다. 반복되는 닫기 토큰도, 채워 넣을 속성 슬롯도 없으므로 요소당 오버헤드가 작고 일정한 상수에 머뭅니다. 아래 실측 데이터가 보여 주는 차이가 바로 이러한 여닫는 태그 중복의 부재에서 비롯됩니다.
이러한 구조 자체는 공개 사양으로 정의되어 있습니다. 핵심 문법(제목, 목록, 링크, 코드 블록, 문단)은 CommonMark Specification새 탭에서 열립니다으로 표준화되었고, 표, 작업 목록, 취소선, 자동 링크 확장은 GitHub Flavored Markdown Spec새 탭에서 열립니다에 정의되어 있습니다. 두 사양을 참고하면 각 문법의 의미와 CommonMark와 GFM의 차이를 확인할 수 있습니다.
각 모델의 정확한 학습 데이터 구성비는 공개되어 있지 않으므로 단정할 수는 없습니다. 다만 검증 가능한 사실은 마크다운이 공개 기술 문서에서 지배적으로 쓰이고 있다는 점, 그리고 주요 AI 모델 제공업체가 공식 프롬프트 가이드에서 마크다운 구조를 명시적으로 권장한다는 점입니다. Anthropic의 Claude 프롬프트 설계 가이드나 Google의 Gemini 프롬프트 가이드 모두 제목과 글머리 기호로 섹션을 명확히 구분할 것을 권장하고 있습니다.
토큰 효율 실측 비교
형식별 효율을 공정하게 비교하기 위해 JSON이 무엇인지 설명하는 짧은 가상의 기술 문서를 작성했습니다. 1개의 h2 제목, 2~3개 문단, 3개 항목 목록, JSON 코드 블록, 3열 표로 구성된 동일 문서를 HTML, 마크다운(CommonMark + GFM), 순수 텍스트(Plain text, 태그 제거 및 탭 구분 표) 세 가지 형식으로 준비했습니다. 사용한 문서의 전문은 아래에 실었고, 재현용 파일의 저장 위치와 실행 방법은 본 섹션 마지막에 적었습니다.
토큰 수는 OpenAI 공식 tiktoken새 탭에서 열립니다 0.13.0 라이브러리로 실측했습니다. cl100k_base는 GPT-3.5 / GPT-4 계열, o200k_base는 GPT-4o 계열에서 사용되는 토크나이저입니다.
| 형식 | 글자 수 (UTF-8) | 바이트 수 | cl100k_base 토큰 | o200k_base 토큰 |
|---|---|---|---|---|
| HTML (클래스 및 aria 속성 포함) | 2,911 | 2,911 | 832 | 835 |
| 마크다운 (GFM) | 1,071 | 1,071 | 243 | 247 |
| 일반 텍스트 (Plain text, 태그 삭제) | 986 | 986 | 213 | 217 |
HTML 대비 마크다운은 토큰 수가 -70.8%(cl100k_base) / -70.4%(o200k_base) 절감되었고, 일반 텍스트는 -74.4% / -74.0% 절감되었습니다. 글자 수로는 마크다운이 -63.2%, 일반 텍스트가 -66.1% 줄었습니다. 1토큰당 글자 수는 HTML이 3.50자인 반면, 마크다운은 4.41자, 일반 텍스트는 4.63자로 나타났습니다. HTML의 특수기호(<, >, =, ")와 속성명 때문에 토크나이저 효율이 현저히 떨어짐을 수치로 확인할 수 있습니다. Claude나 Gemini의 토크나이저는 세부 구현이 달라 절대 수치는 차이가 나지만, BPE 계열 토크나이저 전반에서 HTML의 래퍼 태그로 인한 토큰 증가 경향은 동일합니다.
위 수치는 특정 합성 샘플 문서에서의 실측 결과이며, 실제 웹 페이지에서는 본문 이외의 요소 양에 따라 절감 폭이 달라집니다. 외부 검증에서도 조건에 따라 다른 결과가 보고됩니다.
- Web2MD 벤치마크새 탭에서 열립니다: 3,000단어 기사 기준 HTML 약 8,000토큰 → 마크다운 약 2,800토큰(-67%).
- Beam.ai 2026년 리포트새 탭에서 열립니다: 깔끔한 본문에서 68% 절감, 실제 DOM 구조를 가진 웹 페이지에서는 최대 87% 절감.
- ReleasePad 분석새 탭에서 열립니다: 단순 글머리 기호 목록에서 10~20% 절감, 래퍼 요소가 늘어날수록 절감폭 확대.
절감률은 조건에 따라 다르지만, 어느 쪽이든 마크다운의 토큰 수가 HTML보다 적습니다. 여러 문서를 한 번에 입력하는 경우에는 각 문서에 포함된 불필요한 태그나 속성도 토큰을 소비해 본문에 쓸 수 있는 입력 공간을 줄입니다.
사용한 샘플 문서 (전문)
HTML 버전 (2,911자 / 832 cl100k 토큰)
<section class="prose prose-lg max-w-none">
  <h2 class="text-2xl font-semibold mt-8 mb-4" id="what-is-json">What is JSON?</h2>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.</p>
  <p class="text-base text-gray-700 leading-relaxed mb-4">A JSON document is built from a small set of building blocks:</p>
  <ul class="list-disc pl-6 mb-4 space-y-1">
    <li class="text-base text-gray-700">Objects: unordered collections of key-value pairs wrapped in <code class="bg-gray-100 px-1 rounded">{}</code></li>
    <li class="text-base text-gray-700">Arrays: ordered lists of values wrapped in <code class="bg-gray-100 px-1 rounded">[]</code></li>
    <li class="text-base text-gray-700">Primitives: strings, numbers, booleans, and <code class="bg-gray-100 px-1 rounded">null</code></li>
  </ul>
  <p class="text-base text-gray-700 leading-relaxed mb-4">Here is a minimal example representing a single user record:</p>
  <pre class="bg-gray-900 text-gray-100 p-4 rounded overflow-x-auto mb-4"><code class="language-json">{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}</code></pre>
  <p class="text-base text-gray-700 leading-relaxed mb-4">The core value types and their typical use cases are summarized below.</p>
  <table class="w-full border-collapse mb-4" aria-label="JSON value types">
    <thead>
      <tr class="border-b border-gray-300">
        <th class="text-left p-2 font-semibold">Type</th>
        <th class="text-left p-2 font-semibold">Example</th>
        <th class="text-left p-2 font-semibold">Typical use</th>
      </tr>
    </thead>
    <tbody>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">string</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">"hello"</code></td>
        <td class="p-2">Names, labels, free text</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">number</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">3.14</code></td>
        <td class="p-2">IDs, counts, measurements</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">boolean</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">true</code></td>
        <td class="p-2">Flags, feature toggles</td>
      </tr>
    </tbody>
  </table>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.</p>
</section>
마크다운 버전 / CommonMark + GFM (1,071자 / 243 cl100k 토큰)
## What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

- Objects: unordered collections of key-value pairs wrapped in `{}`
- Arrays: ordered lists of values wrapped in `[]`
- Primitives: strings, numbers, booleans, and `null`

Here is a minimal example representing a single user record:

```json
{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}
```

The core value types and their typical use cases are summarized below.

| Type | Example | Typical use |
| --- | --- | --- |
| string | `"hello"` | Names, labels, free text |
| number | `3.14` | IDs, counts, measurements |
| boolean | `true` | Flags, feature toggles |

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
일반 텍스트(Plain text) 버전 (986자 / 213 cl100k 토큰)
What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

Objects: unordered collections of key-value pairs wrapped in {}
Arrays: ordered lists of values wrapped in []
Primitives: strings, numbers, booleans, and null

Here is a minimal example representing a single user record:

{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}

The core value types and their typical use cases are summarized below.

Type	Example	Typical use
string	"hello"	Names, labels, free text
number	3.14	IDs, counts, measurements
boolean	true	Flags, feature toggles

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
3가지 형식의 원본 파일, OpenAI tiktoken 기반 재현 스크립트(measure.py), 실측 결과 JSON은 저장소의 scripts/benchmarks/markdown-vs-html-for-llms/에 커밋되어 있습니다. python3 -m venv venv && ./venv/bin/pip install tiktoken==0.13.0 && ./venv/bin/python measure.py를 실행하면 위 표와 완전히 동일한 수치가 출력됩니다.
기밀 HTML을 외부에 전송하지 않고 변환하기
토큰 절약과 정보 추출 정확도는 다른 기술 블로그에서도 종종 다뤄집니다. 하지만 대부분의 글이 놓치고 있는 핵심은 변환 과정에서 원본 HTML이 어디를 거치는가입니다.
시중의 수많은 온라인 "HTML to Markdown" 변환 도구는 백엔드 서버에서 변환을 처리합니다. HTML을 붙여넣으면 서버 API로 전송되고, 서버가 변환한 결과를 클라이언트로 반환하는 방식입니다. 공개된 위키백과 문서라면 문제없겠지만 다음과 같은 데이터에는 보안상 적합하지 않습니다.
- Confluence나 Notion에서 내보낸 사내 업무 문서
- 고객명과 주문 정보가 포함된 관리자 화면 HTML 덤프
- 마케팅 문구 승인 전 스테이징 환경의 웹 응답 본문
- 개인정보가 포함된 HTML 이메일 본문
FormatArc의 HTML to Markdown 변환기는 정적 웹 페이지입니다. 마크다운 변환은 브라우저에 포함된 자바스크립트 라이브러리인 Turndown새 탭에서 열립니다을 통해 클라이언트 환경에서 직접 실행됩니다. 붙여넣은 HTML은 브라우저 내에서 파싱되며, 원본 데이터를 외부 서버로 전송하는 네트워크 요청은 전혀 발생하지 않습니다. 직접 확인해 보고 싶다면 브라우저 개발자 도구(DevTools)의 네트워크 탭을 열고, 고유한 문자열을 HTML 입력창에 넣은 뒤 실행 버튼을 눌러 해당 문자열을 포함하는 외부 요청이 발생하지 않음을 확인해 보세요.
"브라우저 내 변환"이란 변환 대상 문서 본문을 외부로 업로드하지 않는다는 의미입니다. 페이지 자체는 CDN에서 HTTPS로 안전하게 배포되며 첫 방문 시 일반적인 접속 분석 스크립트가 로드될 수는 있지만, 사용자가 입력한 문서 데이터는 외부로 나가지 않습니다.
정보 추출 정확도: 표·코드·목록
토큰 절약도 중요하지만, 최종적인 성패는 프롬프트 결과물의 정보 추출 정확도에서 결정됩니다.
표 추출에 관한 평가 결과와, 코드나 목록을 입력할 때의 표기상 특징을 소개합니다.
- 표(테이블) 추출: ReleasePad 분석새 탭에서 열립니다에서 인용된 GPT 계열 모델 평가에 따르면 마크다운 표의 추출 정확도는 60.7%인 반면, 동일한 내용의 HTML 표는 53.6%로 약 7.1%p의 정확도 격차가 나타났습니다.
- 코드 블록 처리: 마크다운의 펜스 코드 블록에 언어 힌트(
```python)를 명시하면 언어 신호가 명확히 보존됩니다. 반면 HTML에서는<pre><code class="language-python">처럼 클래스 속성 내부에 언어 정보가 묻혀 있어 모델이 마크업으로부터 이를 직접 파싱해야 합니다. - 중첩 목록: 마크다운의 들여쓰기는 적은 토큰으로도 강력한 계층 구조 신호를 제공합니다. HTML의
<ul><li><ul><li>중첩 구조는 토큰을 대량 소비할 뿐 아니라 하위 항목이 어느 상위 항목에 속하는지 모델이 잘못 파악할 위험이 있습니다.
이것이 마크다운이 무조건 만능이라는 뜻은 아닙니다(다음 섹션에서 HTML이 유리한 경우를 정리합니다). 적어도 표 추출에서는 마크다운에 의한 토큰 절감에 더해 정확도 향상을 보여 주는 평가 결과도 소개되어 있습니다.
HTML을 유지해야 하는 예외
마크다운이 언제나 최선인 것은 아닙니다. HTML 원본을 그대로 전달하는 것이 더 적절한 3가지 상황이 있습니다.
의미 정보가 속성에 들어 있을 때
aria-label, role, itemprop, microdata, Open Graph 태그 등은 마크다운에 대응하는 문법이 없습니다. 웹 접근성 감사, 상품 메타데이터 추출, schema.org 마크업 유효성 검증 등을 모델에 요청할 때는 HTML 속성 자체가 핵심 분석 대상입니다. 마크다운 변환기로 속성을 지워 버리면 작업의 전제가 무너집니다.
시각적 레이아웃이나 그래픽을 분석해야 할 때
SVG 다이어그램, 임베디드 차트, <iframe> 위젯, 인터랙티브 컴포넌트의 커스텀 데이터 속성은 HTML에만 남고 마크다운에서는 제거됩니다. 2026년 5월 Anthropic의 Thariq Shihipar가 발표한 Using Claude Code: The Unreasonable Effectiveness of HTML새 탭에서 열립니다에서는 사람을 위한 리치 출력을 생성하는 AI 에이전트의 경우 스타일이 적용된 레이아웃, 인터랙티브 요소, 임베디드 SVG를 표현할 수 있는 HTML의 표현력이 높은 토큰 비용을 지불할 가치가 있다고 설명합니다. 입력 측에서는 레이아웃이나 임베디드 요소 자체가 분석 대상이 되는지를 생각합니다. 그 정보를 남겨야 한다면 HTML이 적합한 선택입니다.
출력 결과를 브라우저에서 그대로 렌더링할 때
기존 HTML을 수정하고 결과도 그대로 브라우저에 표시하는 용도에서는 입력부터 출력까지 HTML로 맞추면 도구 구성을 단순하게 만들 수 있습니다. 다만 최종 출력 형식만으로 입력 형식을 정할 필요는 없으며, 입력에서 유지하고 싶은 정보와 변환 처리의 구성에 따라 선택합니다.
실무 워크플로: 웹 페이지에서 LLM용 마크다운까지
웹 페이지나 HTML 이메일의 내용을 불필요한 마크업 비용 없이 안전하게 LLM에 전달하는 실무 워크플로를 소개합니다. HTML에서 마크다운으로의 변환은 브라우저 안에서 합니다. 변환 후 문장을 외부 LLM에 보내는 경우에는 기밀 정보를 포함해도 되는지 별도로 확인하세요.
1단계: HTML 가져오기
Chrome이나 Firefox 브라우저에서 대상 페이지를 마우스 우클릭한 뒤 "페이지 소스 보기"를 선택하거나, 개발자 도구(Elements 탭)에서 <article> 또는 <main> 요소의 outerHTML을 복사합니다. HTML 이메일이라면 메일 클라이언트의 "원본 보기" 메뉴에서 가져옵니다.
본문만 필요하다면 전체 페이지 대신 본문 영역의 태그 트리만 복사하세요. 이 단계에서 내비게이션, 사이드바, 푸터를 제외하면 불필요한 내용을 변환하지 않아도 되고, LLM에 넘기는 토큰 수도 줄일 수 있습니다. 페이지를 통째로 복사해서 <span>과 인라인 스타일이 섞인 상태로 시작하게 됐다면, 무엇을 어떤 순서로 걷어내야 하는지는 HTML 붙여넣기를 마크다운으로 정리하기에 정리해 두었습니다.
2단계: 브라우저에서 변환하기
HTML to Markdown 변환기에 HTML을 붙여넣고 변환을 실행하면 오른쪽 패널에 마크다운이 생성됩니다.
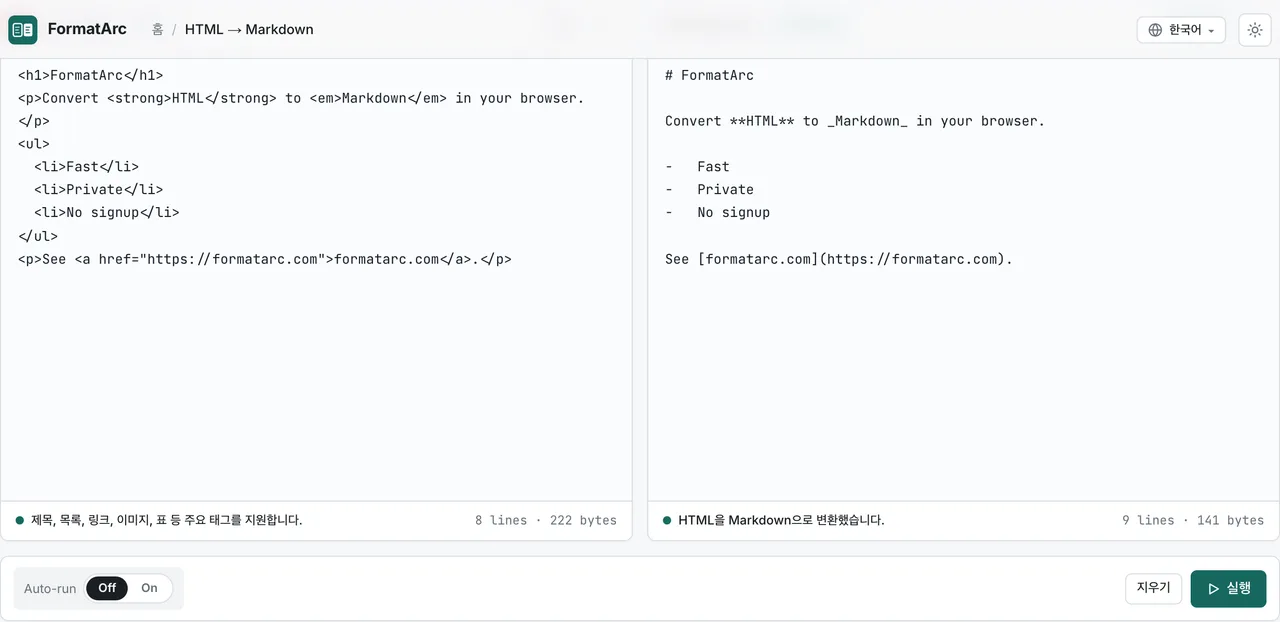
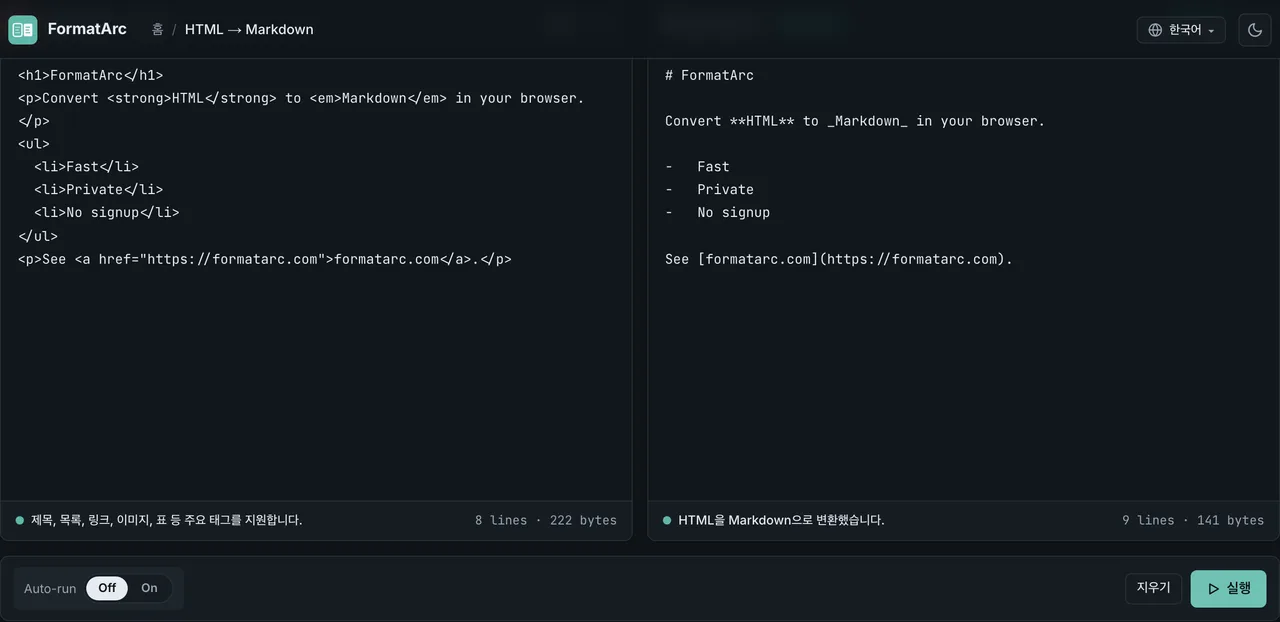
표, 이미지 경로, 셀 병합 처리 등 세부적인 변환 규칙은 HTML to Markdown 변환 가이드에서 다루고 있습니다. 반대로 LLM이 마크다운으로 답변한 결과를 HTML로 되돌리고 싶다면 Markdown to HTML 변환기를 동일하게 로컬 브라우저에서 활용할 수 있습니다.
3단계: 붙여넣기 전에 불필요한 내용 정리하기
변환된 마크다운을 가볍게 훑어보며 본문과 무관한 요소를 수작업으로 지워 줍니다.
- 상단에 글머리 기호로 남은 내비게이션 링크
- 문단 형태로 잔존한 쿠키 동의 배너
- 하단 저작권 표기나 면책 조항
변환 후 불필요한 링크나 안내 문구를 제거하면 본문에 쓸 수 있는 입력 공간을 늘릴 수 있습니다.
4단계: 정리된 마크다운으로 프롬프트 작성하기
문서 요약 및 정보 추출 작업에 활용하기 좋은 프롬프트 템플릿입니다.
다음은 문서 페이지의 마크다운입니다.

작업: <1문장으로 명확히 작성>
제약조건: <출력 형식, 분량 등 지정>

---

<정리한 마크다운 내용 붙여넣기>
마크다운 제목(#, ##)은 모델이 답변할 때 "Syntax 섹션에서는..."과 같이 구체적인 위치를 참조하는 앵커 역할을 하여 답변의 구체성을 높여 줍니다.
LLM 입력용 변환 시 자주 빠지는 함정 5가지
변환 과정에서 흔히 발생하는 5가지 주의점입니다.
- 코드 블록 언어 힌트 누락:
<pre><code class="language-python">은```python형태로 변환되어야 합니다. 일부 변환기는 언어 힌트를 누락하여 모델이 언어를 추측해야 하는 부담이 생깁니다. colspan/rowspan표 깨짐: GFM 표에서는 셀 병합을 표현할 수 없으므로 변환 후 원래 표 구조가 사라질 수 있습니다. 병합 셀을 일반 행과 열로 정리할 수 있으면 CSV로 만든 뒤 CSV to Markdown 변환기로 변환하는 방법도 있습니다. 세부 변환 절차는 CSV to Markdown 변환 가이드를, 정렬 및 이스케이프 문법은 마크다운 표 작성법과 GFM 테이블 치트시트를 참고하세요.- 인라인 HTML 잔존: CommonMark와 GFM 모두 인라인 HTML을 허용합니다. 변환 결과물에
<span class="text-red">중요</span>같은 태그가 남아 있으면 결국 래퍼 태그의 토큰 비용을 다시 치르게 됩니다. 순수 마크다운만 생성하는 변환기를 사용하세요. - 이미지와 링크의 상대 경로: 이미지나 링크의 상대 경로에 주의하세요. 예를 들어
<img src="/images/foo.png">는로 변환되지만, LLM은 그 경로를 가져올 수 없습니다. 참조 대상을 명시할 필요가 있으면 이미지와 링크 모두를 절대 URL로 바꿔 씁니다. 이미지를 참조시키지 않을 경우에는 그 취지를 프롬프트에 명기하세요. - CommonMark와 GFM 사양 차이: 표, 체크리스트, 취소선, 자동 링크는 GFM의 확장 문법입니다. 변환 후 마크다운을 다른 도구로 표시하는 경우에는 그 도구가 GFM에 대응하는지도 확인하세요. 구체적인 사양 차이와 경계는 CommonMark와 GFM의 차이를 참고하세요.
포맷 선택 기준 요약표
| 포맷 | LLM 입력 권장 용도 | 토큰 비용 | 장점 | 단점 |
|---|---|---|---|---|
| 마크다운 (Markdown) | 대부분의 일반 프롬프트 (문서, 기술 블로그, README, 대화 기록) 기본값 | 낮음 | 사전 학습 데이터와 일치하는 구조 신호, 표·목록·코드 보존 | 속성 의미 소실, 인라인 스타일 미지원 |
| 일반 텍스트 (Plain text) | 단순 텍스트 추출, OCR 사후 처리 | 최저 | 가장 가벼움 | 계층 구조 소실, 표나 목록 표현에 부적합 |
| HTML | 접근성 감사, schema.org / microdata 검증, 시각 레이아웃 분석 | 높음 | 태그 속성, 메타데이터, 임베디드 미디어 보존 | 마크업 비용(래퍼 세금), 잡음으로 인한 모델 주의 분산 |
| JSON | 구조화된 레코드, API 응답, 함수 호출(Function Calling) 페이로드 | 중간 | 명확한 스키마, 키 기반 패턴 매칭 용이 | 일반 줄글 문서에는 장황함, 따옴표 오버헤드 |
| XML | Claude 프롬프트 내 섹션 구분 (Anthropic 권장) | 중간 | 프롬프트 구성 요소 간 경계가 명확 | 시작 태그와 종료 태그 때문에 분량이 늘어납니다 |
자주 묻는 질문
ChatGPT 컨텍스트에는 마크다운과 일반 텍스트(Plain text) 중 무엇이 좋나요?
문서에 제목, 목록, 표, 코드 블록 같은 구조가 조금이라도 있다면 마크다운을 권장합니다. 제목이나 목록 같은 구조를 보여 줄 필요가 없는 글이라면 일반 텍스트로 토큰 수를 줄일 수 있습니다. 제목이나 표 같은 구조를 유지하고 싶은 경우에는 토큰 수만으로 판단하지 말고 마크다운을 선택하세요.
Claude 입력에서는 마크다운과 XML을 어떻게 구분해 쓰나요?
Claude는 두 형식 모두 잘 다룹니다. Anthropic의 공식 프롬프트 가이드는 본문 구조를 마크다운 제목과 글머리 기호로 구분할 것을 권장하면서, 프롬프트 각 부분의 경계를 구분하는 용도로는 XML 태그(<instructions>, <context>)의 병용을 권장합니다. 본문은 마크다운으로 쓰고, 지시와 본문의 경계에는 XML 태그를 쓰는 방법이 있습니다.
구조화된 데이터에는 JSON이나 XML이 더 낫지 않나요?
데이터가 본질적으로 테이블이나 레코드 형태(API 응답, 설정값)라면 JSON이 적합합니다. 프롬프트 내 섹션 구분을 명확히 하고 싶다면 XML이 유리합니다(Anthropic 문서가 이 스타일입니다). 줄글에 제목이나 목록을 붙여 넘기는 용도에서는 마크다운의 간결한 표기가 적합합니다.
웹 페이지 URL을 직접 LLM용 마크다운으로 변환할 수 있나요?
정적 웹 브라우저 환경에서 임의의 외부 URL을 클라이언트 사이드만으로 직접 가져오는 것은 브라우저 보안 정책(CORS)으로 인해 불가능합니다. 웹 페이지를 브라우저에서 저장(Ctrl+S / Cmd+S)하거나 개발자 도구에서 소스를 복사한 뒤 HTML to Markdown 변환기에 붙여넣으세요. 변환 자체는 브라우저 내에서 안전하게 완결됩니다.
FormatArc 변환은 정말 브라우저 안에서만 실행되나요?
네, 변환 작업은 100% 브라우저 내에서 실행됩니다. 붙여넣은 HTML은 페이지에 내장된 Turndown새 탭에서 열립니다 자바스크립트 라이브러리로 로컬 파싱되며 입력 데이터가 포함된 외부 네트워크 요청은 전혀 발생하지 않습니다. CDN 및 접속 분석 스크립트 로딩은 일반 정적 사이트 방문과 동일하지만 사용자가 입력한 텍스트 데이터는 전송되지 않습니다.
정리
- 본문 요약이나 추출이 목적이라면 마크다운(Markdown)을 기본 입력 형식으로 하면 좋습니다. 불필요한 태그와 속성을 줄이고 본문 중심의 입력으로 정리할 수 있습니다.
- 자체 실측에서 동일 내용 기준 약 71%의 토큰 절감(cl100k_base)을 기록했으며, 외부 벤치마크에서도 68~87% 수준의 절감 효과가 확인되었습니다.
- 사내 문서, 고객 데이터, 미공개 초안 등 기밀 HTML을 다룰 때는 변환 도구의 안전성이 중요합니다. HTML to Markdown 변환기는 브라우저 내에서 로컬로 동작하여 원본이 외부 서버로 전송되지 않습니다.
- LLM의 마크다운 답변을 HTML로 변환하려면 Markdown to HTML 변환기와 Markdown to HTML 변환 가이드를, 데이터 테이블 변환이 필요하다면 CSV to Markdown 변환기를 함께 활용할 수 있습니다.