把 PDF 转成 Markdown 时,扫描页可能什么都出不来,图片会消失,表格的列会错位。操作本身只是选文件、复制结果。在这之前先确认 PDF 类型,在这之后和原件对照,加上这两道检查,就更容易发现缺失的内容。
本文把包含这两道检查的流程分成 5 步,再按症状整理处理方法。转换修不好的表格,从电子表格或 JSON 重建。
转换前先确认 PDF 的类型
有的 PDF 把文字当作文字保存,有的只是把每一页存成一张图片。属于哪一种,决定了转换能提取出什么。
一个快速的判断方法,是在 PDF 阅读器里用鼠标拖选一行正文。能选中,说明文件里有文字信息。什么都选不中,这一页多半只是图片。不过,作者禁止复制的 PDF 也可能选不中文字,所以还要在阅读器的文档属性里看一下安全设置。
| PDF 类型 | 判断方法 | 转换成 Markdown 的结果 |
|---|---|---|
| 含文字的 PDF | 正文可以拖选 | 标题、段落、表格被重组为 Markdown |
| 未做 OCR 的扫描版 PDF | 每一页都选不中文字 | 拿不到任何文字,需要先做 OCR(文字识别) |
| 混合型 PDF | 只有部分页面选不中 | 选不中的页面内容会缺失 |
| 有密码保护的 PDF | 打开时要求输入密码 | 解除保护之前无法载入 |
能选中文字并不代表一定能正确转换。扫描后做过 OCR 的 PDF 也能选中文字,但这些文字是 OCR 的识别结果,识别错的地方会原样进入 Markdown。拖选测试只能用来判断能不能转换,不能用来预估转换质量。
用 FormatArc 把 PDF 转成 Markdown 的 5 个步骤
这里使用 PDF 转 Markdown。转换在浏览器内完成,PDF 不会发送到服务器,所以不想上传到外部服务的文件,也可以在自己的设备上先看看结果。公司内部资料能否这样处理,仍需遵守所在单位的规定。
- 用上一节的方法,确认 PDF 里有文字
- 打开 PDF 转 Markdown,把 PDF 拖进来,或点击“选择文件”
- 看结果上方有没有出现提示。每种提示的含义见下表
- 把结果和原件对照。Markdown 输出里不保留分页,所以要逐页翻看原件,在输出里找每一页的标题或第一句话
- 用“复制”或“下载”取出 Markdown。如果有表格错乱,按后文的方法重建后替换进去
第 3 步可能出现的提示有三种。
| 提示内容 | 含义 | 下一步 |
|---|---|---|
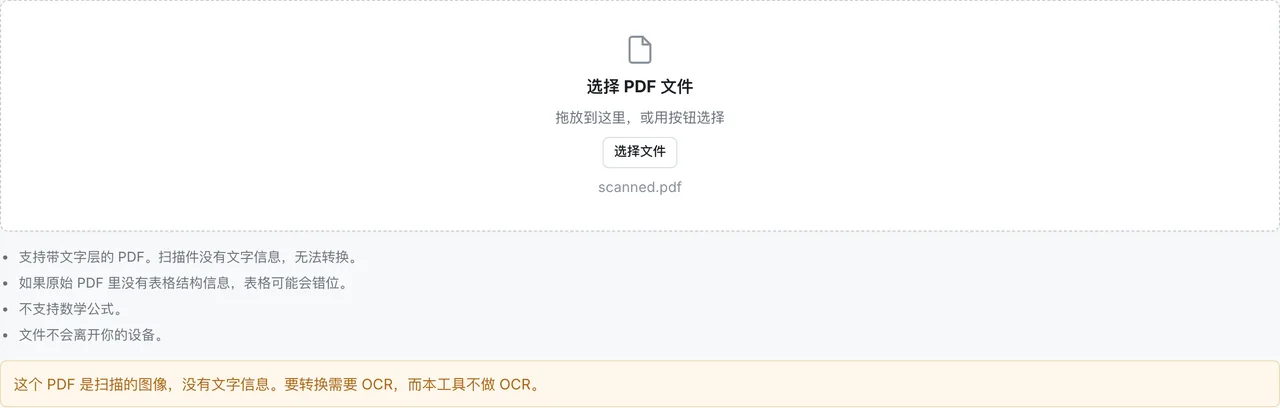
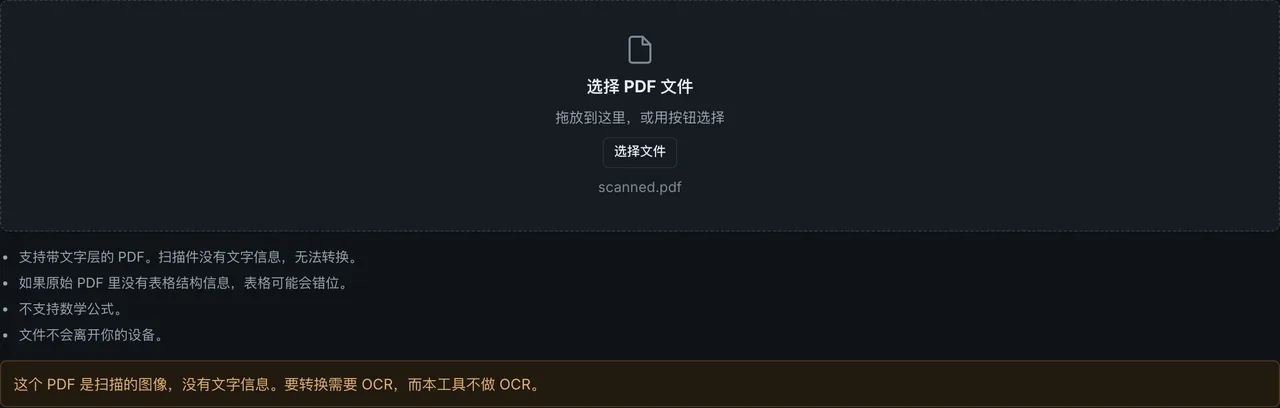
| 这是扫描的图像,没有文字信息 | 一个字都读不出来,所以没有任何输出 | 用 OCR 识别文字 |
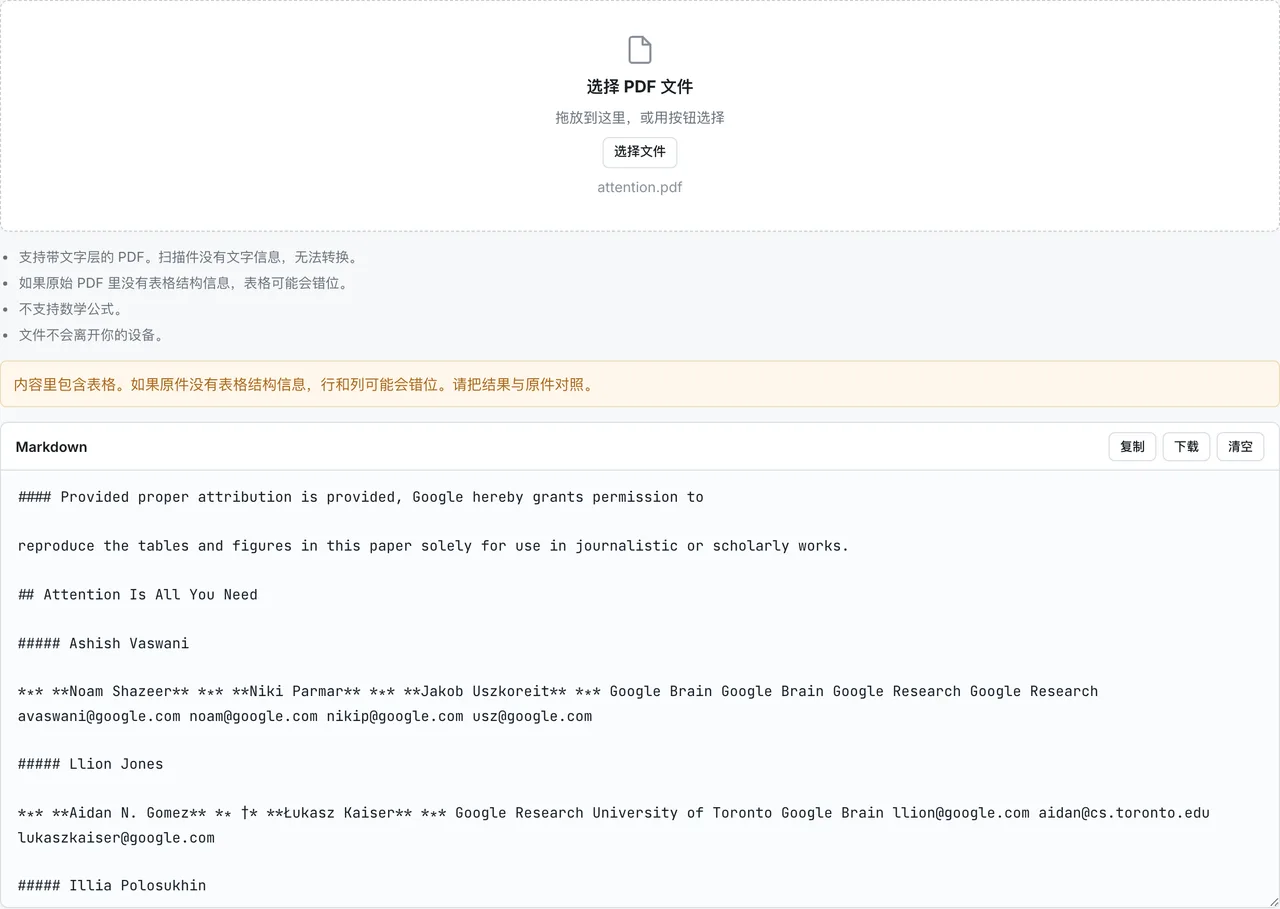
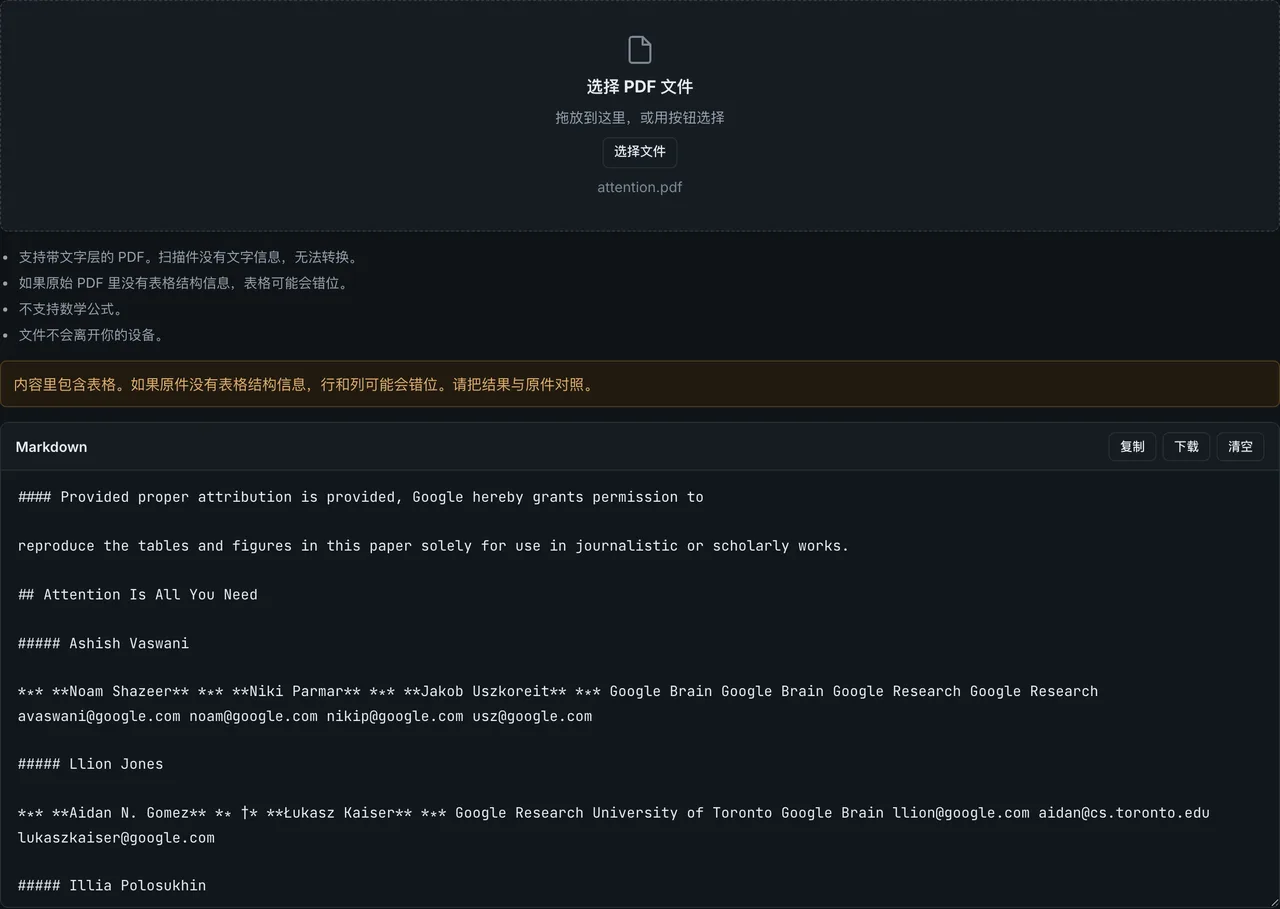
| 内容里包含表格 | 推测并重建了表格结构 | 对照原件检查表格的行和列 |
| 只提取了文本,没有生成标题和表格 | 部分文字无法稳定提取,因此没有生成结构 | 手动补上标题 |
按症状查找原因和处理方法
转换结果不对劲时,从看到的症状出发逐步确定原因。最后一列表示 FormatArc 的工具(PDF 转 Markdown 和表格转换工具)能否处理。
| 症状 | 可能的原因 | 处理方法 | FormatArc 能否处理 |
|---|---|---|---|
| 什么都没有输出 | 未做 OCR 的扫描版 PDF | 先做 OCR | 不能 |
| 部分页面内容缺失 | 混有只有图片的页面 | 只对这些页面做 OCR | 仅限有文字的页面 |
| 正文顺序颠倒,或变成了表格 | 多栏的阅读顺序推测错了 | 丢掉变成表格的部分,重新排成段落 | 不能(需手动) |
| 表格列错位,或表格消失 | PDF 没有保存表格结构 | 只重建表格 | 可以(用 CSV 转 Markdown 或 JSON 转 Markdown) |
| 图里的文字没有出来 | 不读取图和图片里的文字 | 导出图片后做 OCR,或手动录入 | 不能 |
| 出现密码错误 | 受保护的 PDF | 解除保护后重新载入 | 解除后可以 |
| 公式乱掉 | 不支持公式 | 换用支持公式的转换方法 | 不能 |
扫描版 PDF 没有任何输出:需要 OCR
扫描版 PDF 相当于每一页的照片,没做过 OCR 的话,里面没有文字数据。PDF 转 Markdown 识别出这种文件后,不会继续转换,而是提示没有文字信息。
这种情况下,请先用带 OCR 功能的软件识别文字。OCR 还原的是文字,并不保证还原表格结构和多栏的阅读顺序。转换做过 OCR 的 PDF 之后,表格和多栏页面要格外仔细地和原件核对。
只有部分页面的内容缺失
在文字页和纯图片页混在一起的 PDF 中,纯图片页的内容不会输出。2026-10-13 我们用 Chromium 生成了一个 2 页的 PDF,第 1 页是文字,第 2 页只有一张图片,转换后输出只有第 1 页的文字,也没有出现任何提示。
因为没有提示,只看输出很可能漏掉缺页。第 4 步要求逐页核对,原因就在这里。找到缺失的页面后,只对这一页做 OCR,再把文字补进 Markdown。
多栏正文顺序颠倒,或变成了表格
在两栏、三栏的页面上,转换工具需要推测按什么顺序读取文字。2026-10-13 用一个简单的两栏 PDF 测试时,文字按先左栏、后右栏的正确顺序输出了。
另一方面,多栏排版本身也可能被判定为表格。我们实际转换一份央行报告时,标题和正文全部进入了表格单元格。具体经过、实例以及表格列错位的原理,整理在 PDF 转 Markdown 后表格错乱?7 个文档实测告诉你原因和修复方法 中。正文变成表格时,与其修单元格,不如直接丢掉这个表格,把正文重新排成段落,这样更快。
图和图片里的文字没有出来
嵌在 PDF 里的图和照片不会输出到 Markdown,也不会留下 ![]() 这样的图片语法。2026-10-13 我们用一个在两段正文之间夹了一张含文字图片的 PDF 测试,结果只输出了前后的正文,图片里的文字消失了。
需要图表里的数值或示意图的标签时,可以在 PDF 阅读器等工具里把图导出为图片,再做 OCR。数量不多的话,对照原件手动录入可能更快。如果想把图片本身放进 Markdown,可以用  的形式插入导出的文件。
有密码保护的 PDF 会报错
载入有密码保护的 PDF 时,PDF 转 Markdown 会提示先解除保护。如果你知道密码并且有权解除,可以用 PDF 编辑软件另存一份解除保护的副本,再选择这个文件。
公式不会被转换
PDF 转 Markdown 不支持公式。公式较多的论文里,符号会变成零散的字符,或者顺序被打乱。如果需要以 LaTeX 形式取出公式,使用支持公式的转换工具更稳妥。
用 Markdown 表格转换工具重建错乱的表格
大多数 PDF 并没有把看得见的表格以表格结构保存。转换工具根据线条和文字的位置等信息推测表格,所以会出现列错位,或者表格被当成普通文字排出来。金额、统计值这类错一格就会改变意思的表格,与其修改转换结果,不如重建更可靠。用哪个工具,取决于你能以什么形式拿到原始数据。
能粘贴到电子表格时,经由 CSV 转换
在 PDF 阅读器里复制表格区域,粘贴到 Excel 或 WPS 表格中。如果粘贴后列错位了,就在这里修正。在电子表格里修正列错位,比在 Markdown 表格里容易得多。
整理好后导出为 CSV,粘贴到 CSV 转 Markdown 就能得到 Markdown 表格。
品名,数量,单价
苹果,3,120
香蕉,5,80
上面的 CSV 会变成下面的 Markdown 表格。
| 品名 | 数量 | 单价 |
| --- | --- | --- |
| 苹果 | 3 | 120 |
| 香蕉 | 5 | 80 |
分隔符和单元格内逗号的处理,参见 CSV 转 Markdown 表格的完整指南。
能拿到原始数据的 JSON 时,直接转换
如果 PDF 报表是由公司内部系统或 API 生成的,而你能拿到同一份数据的 JSON,就不必经过 PDF。用 JSON 转 Markdown 直接从 JSON 生成表格,比从 PDF 读取更可靠。嵌套的对象会展开成 address.city 这样的列。
Markdown 表格不属于 CommonMark 的核心规范,而是作为 GitHub Flavored Markdown 的扩展来定义的(GFM 规范的 Tables extension在新标签页中打开),这份规范里没有合并单元格的写法。PDF 表格里如果有合并单元格,就需要改写结构,例如把值重复写进每个单元格,或者留空一格并在表格下方加注说明。
按 PDF 的内容选择转换方法
前面的症状中,有些是 PDF 转 Markdown 处理不了的。请根据 PDF 的内容选择方法。
| PDF 的内容 | 合适的方法 |
|---|---|
| 有文字,且文件不想发送到任何地方 | 在浏览器内转换(PDF 转 Markdown) |
| 扫描页,或含有纯图片页 | 先用 OCR 软件识别文字,再转换 |
| 公式较多 | 能把公式输出为 LaTeX 的转换工具 |
| 大量格式相同的 PDF | 把命令行工具写进脚本批量处理 |
转换结果检查清单
转换完成后,使用之前请确认以下几点。
- 原件每一页的内容,在输出里是否都能找到
- 标题数量和原件是否差别不大。只有一行的短段落有时会被当成标题
- 表格的行数和列数是否与原件一致
- 除了表格的第一行和最后一行,是否也抽查了几行中间的内容
- 原来有图和图片的地方,是否缺了需要的信息
- 正文里是否混有读不通的词或乱码
常见问题
PDF 会被上传吗?
不会。转换全部在浏览器内完成。
扫描版 PDF 能转成 Markdown 吗?
用 PDF 转 Markdown 不能。做过 OCR 的 PDF 可以转换,但 OCR 识别错误会原样保留。
图片会包含在 Markdown 里吗?
不会。需要的图片请单独导出,再用 Markdown 的图片语法插入。
转换时间太长,中途停止了
PDF 转 Markdown 在 120 秒内没有完成转换时会中断处理。页数较多的 PDF,请先把需要的页面拆成单独的 PDF 再转换。