Web ページの HTML ソースをコピーして ChatGPT や Claude、Gemini に貼り付ける場合、本文以外のタグや属性も入力に含まれます。本文の要約や抽出が目的の場合、不要なタグや属性がトークンを消費し、処理対象を分かりにくくすることがあります。コピーした HTML には div のラッパー、class 属性、インラインスクリプト、トラッキング用ピクセルなど、モデルが本文を理解するうえで不要な要素が大量に含まれています。Markdown に変換すると、不要なタグや属性を取り除き、見出しやリストなどの構造を保ちながら、本文を中心とした入力に整理できます。
この記事では Markdown と HTML を LLM 入力としての観点で比較し、実測値で違いを示します。HTML を渡すべき例外的なケースにも触れたうえで、社内 HTML を外部のサーバーに送信せずブラウザ内で変換する手順を紹介します。
まず結論から
LLM への入力には Markdown を選んでください。今回のサンプルでは、Markdown のトークン数は HTML の約 3 割でした。削減幅は、元の HTML に含まれるタグや属性の量によって変わります。外部の評価では、表の抽出精度で Markdown が HTML を上回った例も紹介されています。HTML を HTML to Markdown に貼り付けて変換し、結果をプロンプトにコピーするだけです。変換処理はブラウザ内で完結し、貼り付けた HTML は FormatArc にも第三者サービスにもアップロードされません。
LLM はフォーマットをどう読むか
LLM はブラウザのようにレンダリングされた HTML を「見て」いるわけではありません。生のソースをトークン列として処理します。角括弧、クラス名、インラインスタイル、それらすべてが、本来コンテンツを置きたいコンテキストウィンドウから容量を奪います。
ここから 2 つの帰結が生まれます。
- ラッパー要素の多い HTML を渡すと、指示文・例示・モデルの応答を入れるスペースが減ります
class="text-base text-gray-700"やdata-*属性、アクセス解析用のタグなど、本文の処理に不要な情報が、抽出や書き換え対象の本文をモデルが見失う原因になります
Markdown は同じ構造 (見出し・リスト・リンク・コード) を、開閉タグの代わりに 1〜2 文字の記号で表現します。結果として短くなり、しかも LLM が訓練データで頻繁に目にしてきたパターンに近くなります。GitHub の README、ドキュメントサイト、Stack Overflow の投稿、フォーラムのスレッドなど、公開された技術文書の大半は Markdown です。
Markdown のトークン数が少なくなる理由の一つは、HTML と構造の表し方が異なることです。ページからコピーした HTML では、多くの要素が開始タグと終了タグで囲まれています。たとえば、段落は <p>...</p>、リスト項目は <li>...</li> と表します。一部の終了タグは省略できますが、コピー元の出力に両方のタグが含まれていれば、その分のトークンも消費します。要素を入れ子にするほど、開始タグと終了タグの記述が増えます。表のセル内にリストを置く場合は、行・セル・リストのそれぞれをタグで囲みます。各タグはさらに class、id、style、data-* 属性を持てるため、本文の理解に役立たない属性も、文字数とトークン数を増やします。Markdown は同じ構造を、一度だけ置く単独のマーカーで表現します。見出しは #、リスト項目は -、テーブルの列境界は |、段落区切りは空行です。繰り返す閉じトークンも、埋める属性スロットもないので、要素あたりのオーバーヘッドは属性やネストの深さで増えるラッパーペアではなく、小さな定数で済みます。下の実測値が定量化しているのはこの差であり、原因は開閉タグの重複が無いことにあります。
Markdown の構文は、公開された仕様で定義されています。中核となる構文 (見出し・リスト・リンク・インラインコードと、バッククォートなどで囲むコードブロック・段落) は CommonMark Specification別タブで開きます で標準化され、表・タスクリスト・打ち消し線・自動リンクの拡張は GitHub Flavored Markdown Spec別タブで開きます で定義されています。これらの仕様を参照すれば、各構文の意味や CommonMark と GFM の違いを確認できます。
各モデルの正確な訓練データ比率は公開されていないので、ここを断定的に語るのは避けます。検証可能なのは、Markdown が公開技術文書で広く使われていること、そして主要モデルベンダーが自社のプロンプト設計ガイドで明示的に Markdown 風の構造を推奨していることです。たとえば Anthropic の Claude プロンプト設計ガイドや Google の Gemini プロンプト設計ガイドは、いずれも見出しと箇条書きでセクションを区切るよう案内しています。
トークン効率の実測比較
公平に比較するため、JSON とは何かを説明する短い技術文書を新たに用意しました。比較用の文書には、レベル 2 の見出し、2〜3 段落、3 項目の箇条書き、JSON のコードブロック、3 列の表を含めました。同じ内容を HTML、Markdown、プレーンテキストの 3 形式で作成しています。HTML 版には、CMS のページを想定したコンテナ要素、Tailwind 風のクラス、aria 属性を加えました。Markdown 版では、CommonMark に GFM別タブで開きます の表記法を加えています。プレーンテキスト版ではタグを除去し、表をタブ区切りで表しました。使用した文書の全文は、以下に掲載しています。再現用ファイルの保存先と実行方法は、本節末尾に記載しています。
トークン数は OpenAI 公式の tiktoken別タブで開きます 0.13.0 で実測しました。cl100k_base は GPT-3.5 / GPT-4 系、o200k_base は GPT-4o 系で採用されている tokenizer です。
| 形式 | 文字数 (UTF-8) | バイト数 | cl100k_base のトークン数 | o200k_base のトークン数 |
|---|---|---|---|---|
| HTML (クラスと aria 付き) | 2,911 | 2,911 | 832 | 835 |
| Markdown (GFM) | 1,071 | 1,071 | 243 | 247 |
| Plain text (タグ削除) | 986 | 986 | 213 | 217 |
HTML と比べたトークン数の削減率は、Markdown が cl100k_base で 70.8%、o200k_base で 70.4% でした。プレーンテキストでは、それぞれ 74.4%、74.0% です。文字数は、Markdown が 63.2%、プレーンテキストが 66.1% 減りました。1 トークンあたりの文字数は、HTML が 3.50、Markdown が 4.41、プレーンテキストが 4.63 でした。HTML では、タグの記号や属性名の記述がトークン数を押し上げています。Claude や Gemini の tokenizer は実装が異なるため絶対値はずれますが、HTML のタグや属性の分だけトークン数が増え、同じ方向に差が出るのは BPE 系 tokenizer に共通です。
上記はあくまで「この合成サンプル文書」での実測値です。実際の Web ページでは、本文以外の要素の量によって削減幅が変わります。外部の検証でも、条件ごとに異なる結果が報告されています。
- Web2MD のベンチマーク別タブで開きます: 3,000 語の記事の例では、HTML の約 8,000 トークンが Markdown で約 2,800 トークンになり、約 67% 減っています
- Beam.ai の 2026 年レポート別タブで開きます: 不要な要素を除いた本文では 68%、実際の Web ページでは最大 87% のトークン削減が報告されています
- ReleasePad の分析別タブで開きます: 単純な箇条書きで 10〜20% 削減、ラッパー要素が増えるほど差が拡大
削減率は条件によって異なりますが、いずれも Markdown のトークン数が HTML より少ないという結果です。複数の文書を一度に入力する場合は、それぞれの文書に含まれる不要なタグや属性もトークンを消費し、本文に使える入力枠を圧迫します。
使用したサンプル文書(全文)
HTML 版(2,911 文字、cl100k_base で 832 トークン)
<section class="prose prose-lg max-w-none">
  <h2 class="text-2xl font-semibold mt-8 mb-4" id="what-is-json">What is JSON?</h2>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.</p>
  <p class="text-base text-gray-700 leading-relaxed mb-4">A JSON document is built from a small set of building blocks:</p>
  <ul class="list-disc pl-6 mb-4 space-y-1">
    <li class="text-base text-gray-700">Objects: unordered collections of key-value pairs wrapped in <code class="bg-gray-100 px-1 rounded">{}</code></li>
    <li class="text-base text-gray-700">Arrays: ordered lists of values wrapped in <code class="bg-gray-100 px-1 rounded">[]</code></li>
    <li class="text-base text-gray-700">Primitives: strings, numbers, booleans, and <code class="bg-gray-100 px-1 rounded">null</code></li>
  </ul>
  <p class="text-base text-gray-700 leading-relaxed mb-4">Here is a minimal example representing a single user record:</p>
  <pre class="bg-gray-900 text-gray-100 p-4 rounded overflow-x-auto mb-4"><code class="language-json">{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}</code></pre>
  <p class="text-base text-gray-700 leading-relaxed mb-4">The core value types and their typical use cases are summarized below.</p>
  <table class="w-full border-collapse mb-4" aria-label="JSON value types">
    <thead>
      <tr class="border-b border-gray-300">
        <th class="text-left p-2 font-semibold">Type</th>
        <th class="text-left p-2 font-semibold">Example</th>
        <th class="text-left p-2 font-semibold">Typical use</th>
      </tr>
    </thead>
    <tbody>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">string</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">"hello"</code></td>
        <td class="p-2">Names, labels, free text</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">number</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">3.14</code></td>
        <td class="p-2">IDs, counts, measurements</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">boolean</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">true</code></td>
        <td class="p-2">Flags, feature toggles</td>
      </tr>
    </tbody>
  </table>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.</p>
</section>
Markdown 版 / CommonMark + GFM(1,071 文字、cl100k_base で 243 トークン)
## What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

- Objects: unordered collections of key-value pairs wrapped in `{}`
- Arrays: ordered lists of values wrapped in `[]`
- Primitives: strings, numbers, booleans, and `null`

Here is a minimal example representing a single user record:

```json
{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}
```

The core value types and their typical use cases are summarized below.

| Type | Example | Typical use |
| --- | --- | --- |
| string | `"hello"` | Names, labels, free text |
| number | `3.14` | IDs, counts, measurements |
| boolean | `true` | Flags, feature toggles |

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
Plain text 版(986 文字、cl100k_base で 213 トークン)
What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

Objects: unordered collections of key-value pairs wrapped in {}
Arrays: ordered lists of values wrapped in []
Primitives: strings, numbers, booleans, and null

Here is a minimal example representing a single user record:

{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}

The core value types and their typical use cases are summarized below.

Type	Example	Typical use
string	"hello"	Names, labels, free text
number	3.14	IDs, counts, measurements
boolean	true	Flags, feature toggles

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
3 形式の生ファイル・OpenAI tiktoken を使った再現スクリプト(measure.py)・実測結果の JSON は、リポジトリの scripts/benchmarks/markdown-vs-html-for-llms/ にコミットしてあります。python3 -m venv venv && ./venv/bin/pip install tiktoken==0.13.0 && ./venv/bin/python measure.py を実行すれば、本節冒頭の表とまったく同じ数値が出ます。
機密 HTML を外部に送らずに変換する
変換ツールを選ぶ際は、HTML が外部のサーバーに送信されるかどうかも確認する必要があります。
オンラインの「HTML to Markdown」変換ツールの多くはバックエンドサーバー上で処理しています。入力した HTML がツールのサーバーに送信され、サーバーで Markdown に変換した結果が返ってきます。公開済みの Wikipedia 記事ならそれで構いません。しかし次のようなケースには向きません。
- Confluence や Notion からエクスポートした社内ドキュメント
- 顧客名が含まれる管理画面の HTML ダンプ
- 承認前の広告文を含むステージング環境の HTML
- 個人情報入りの HTML メール
FormatArc の HTML to Markdown は静的ページです。Markdown 変換はページに同梱された JavaScript の Turndown別タブで開きます ライブラリで実行されます。貼り付けた HTML はブラウザ内でパースされ、ソースを外部に送信するネットワークリクエストは発生しません。確認するには、ブラウザの DevTools でネットワークタブを開いてください。HTML 入力欄に識別しやすい文字列を含む HTML を貼り付け、実行ボタンを押します。その後、その文字列を含む通信が外部に送られていないか確認してください。
ここでいうブラウザ内変換とは、HTML 本文を外部のサーバーに送信せず、ブラウザ内で処理することです。ページ自身は CDN から HTTPS で配信されますし、初回訪問時に標準的なアクセス解析が読み込まれる場合はあります。それでも変換するドキュメント本体が外部に出ることはありません。
抽出精度: 表・コード・リスト
トークン数は分かりやすい指標ですが、最終的に役立つかは抽出精度で決まります。
表の抽出に関する評価結果と、コードやリストを入力するときの記法上の特徴を紹介します。
- 表の抽出: ReleasePad の分析別タブで開きます で紹介されている GPT 系モデルの評価では、Markdown 表 60.7% vs HTML 表 53.6%。同じ元データに対して 7 ポイントの差です
- コードブロック: Markdown のコードブロックに
```pythonのように言語名を付けると、コードと一緒に使用言語を伝えられます。HTML では<pre><code class="language-python">のようにクラス属性内に埋もれ、モデルがマークアップから掘り出す必要があります - ネストしたリスト: Markdown では、インデントによってリストの入れ子関係を簡潔に示せます。HTML の
<ul><li><ul><li>の入れ子はトークンを消費し、ときにモデルが「この子要素がどのリストに属するか」を取り違えます
これだけで Markdown が万能、というわけではありません (次節で HTML が勝つ場面を整理します)。少なくとも表の抽出では、Markdown によるトークン削減に加え、精度の向上を示す評価結果も紹介されています。
HTML を選ぶべき例外
Markdown が常に正解ではありません。HTML をそのまま貼るほうが妥当な場面が 3 つあります。
意味が属性に乗っているとき
HTML の属性やメタデータには、aria-label、role、itemprop、microdata、Open Graph タグなど、Markdown の記法だけでは同じ情報を表せないものがあります。アクセシビリティの監査、商品メタデータの抽出、schema.org マークアップの検証などをモデルに依頼する場合、HTML 属性そのものが分析対象です。Markdown コンバータで属性を落としてしまうと、タスクの前提が壊れます。
レイアウトや視覚要素を分析するとき
SVG 図、埋め込みチャート、<iframe> ウィジェット、インタラクティブコンポーネントのカスタムデータ属性などは HTML には残り、Markdown では消えます。Anthropic の Thariq Shihipar が 2026 年 5 月に公開した Using Claude Code: The Unreasonable Effectiveness of HTML別タブで開きます では、人が見る画面を AI エージェントに作らせる用途では、トークン数が増えても HTML の表現力を生かす価値があると説明されています。具体例として、スタイル付きのレイアウト、操作できる要素、埋め込み SVG が挙げられています。入力側では、レイアウトや埋め込み要素そのものが分析対象になるかを考えてください。それらの情報を残す必要がある場合は、HTML が候補になります。
結果をそのまま HTML として描画する場合
既存の HTML を修正し、結果もそのままブラウザで表示する用途では、入力から出力まで HTML でそろえるとツール構成を単純にできることがあります。ただし、最終的な出力形式だけで入力形式を決める必要はありません。入力で保持したい情報と、変換処理の構成に応じて選んでください。
実用ワークフロー: HTML から LLM 向け Markdown へ
日常的なケース、つまり「Web ページや HTML メールがあり、マークアップの税を払わずに LLM に内容を渡したい」場合のワークフローを示します。HTML から Markdown への変換は、ブラウザ内で行います。変換後の文章を外部の LLM に送る場合は、機密情報を含めてよいか別途確認してください。
ステップ 1: HTML を取得する
Chrome や Firefox で対象ページを右クリックし、「ページのソースを表示」を選んで HTML をコピーします。DevTools の Elements パネルで、<article> や <main> の要素全体の HTML(outerHTML)をコピーする方法もあります。HTML メールならメールクライアントの「ソースを表示」から取得します。
本文だけが必要なら、本文を含む要素の HTML だけをコピーしてください。この段階でナビゲーション・サイドバー・フッターを除くと、不要な内容を変換せずに済み、LLM に渡すトークン数も減らせます。部分木を選ばずページごとコピーしてしまい、<span> やインラインスタイルが混ざった状態から始めるときの手順は HTML の貼り付けを Markdown に直す にまとめています。
ステップ 2: ブラウザで変換する
HTML to Markdown に貼り付けて実行ボタンを押すと、右側に Markdown が出ます。
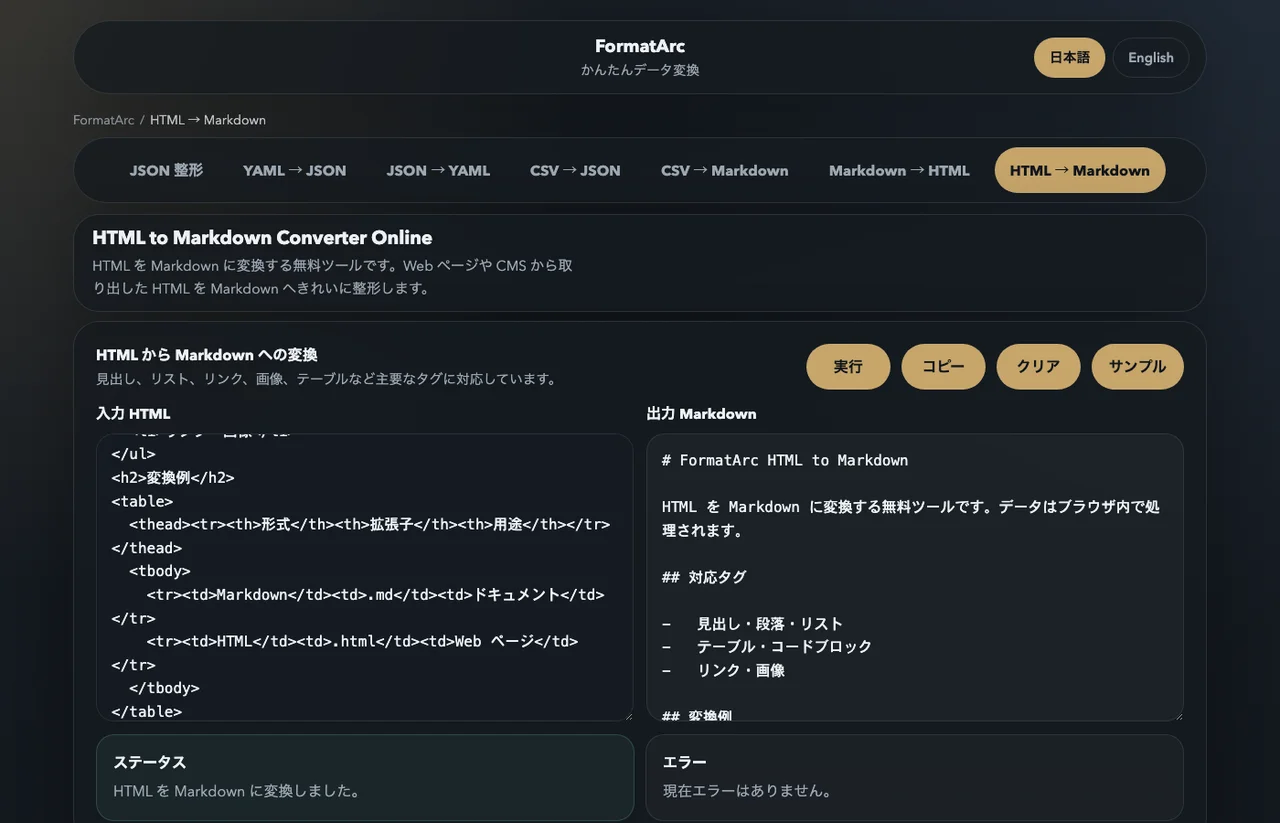
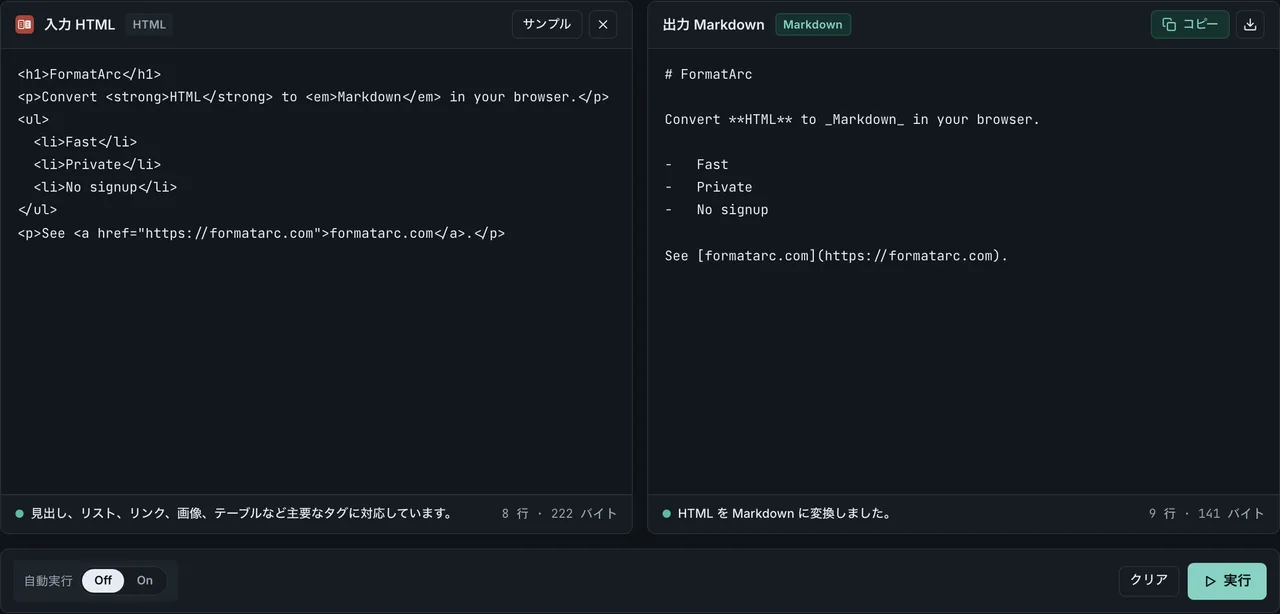
変換そのものの詳細 (表・画像パス・colspan の取り扱い) は HTML to Markdown 変換ガイド に整理しています。モデルが Markdown で返した回答を HTML に変換する場合は、Markdown to HTML を使えます。こちらもブラウザ内で処理します。
ステップ 3: 貼り付ける前に整える
変換後の Markdown を眺めて、残骸を削ります。
- 冒頭にリスト化されたナビゲーションリンク
- 段落の形で残ったクッキー同意バナー
- フッターの著作権表記
変換後に不要なリンクや案内文を取り除くと、本文に使える入力枠を増やせます。
ステップ 4: 整えた Markdown でプロンプトを書く
抽出系タスクで使い回しやすい雛形は次のとおりです。
以下はドキュメントページの Markdown です。

タスク: <1 文で書く>
制約: <出力形式や長さの指定>

---

<整えた Markdown を貼り付け>
Markdown の見出しがあれば、「Syntax の節を要約して」のように、処理対象の節を指定できます。
LLM 入力用に変換する際の落とし穴
頻出する 5 点に注意してください。
- コードブロックの言語ヒントが消える。
<pre><code class="language-python">は```pythonに変換されるべきですが、ヒントを落とすコンバータもあります。落ちるとモデルが言語を推測する必要が生じます colspan/rowspanを含む表が崩れる。GFM 形式の表ではセルの結合を表せないため、変換後に元の表の構造が失われることがあります。結合セルを通常の行と列に整理できる場合は、CSV にしてから CSV to Markdown で変換する方法もあります。変換手順は CSV を Markdown テーブルに変換する方法、配置やエスケープの記法は、Markdown 表の書き方 と GFM テーブル チートシート を参照してください- 生の HTML が Markdown 中に残る。CommonMark も GFM もインライン HTML を許容します。
<span class="text-red">important</span>がモデルに渡る Markdown に残ると、不要なタグや属性が残り、その分のトークンを消費します。可能なら純粋な Markdown だけを生成するコンバータを選び、本当に必要な構造 (数式・複雑な表) でのみ HTML を残してください - 画像やリンクの相対パスに注意してください。たとえば
<img src="/images/foo.png">はになりますが、LLM はそのパスを取得できません。参照先を明示する必要がある場合は、画像とリンクの両方を絶対 URL に書き換えます。画像を参照させない場合は、その旨をプロンプトに明記してください - CommonMark と GFM の差。表・タスクリスト・打ち消し線・自動リンクは GFM の拡張です。変換後の Markdown を別のツールで表示する場合は、そのツールが GFM に対応しているかも確認してください。対応する構文の違いは、CommonMark と GFM の違い を参照してください
フォーマット選定の早見表
| 形式 | LLM 入力としての推奨用途 | トークンコスト | 強み | 弱み |
|---|---|---|---|---|
| Markdown | 大半の入力 (ドキュメント、記事、README、チャットログ) のデフォルト | 低 | 訓練データに近い構造シグナル、表・リスト・コードが残る | HTML の属性に含まれる情報やインラインスタイルを失う |
| Plain text | 純粋なテキスト抽出、OCR 的タスク | 最小 | 最も軽い | 構造が消える、リストや表に不向き |
| HTML | アクセシビリティ監査、schema.org / microdata、視覚レイアウトの推論 | 高 | 属性・意味・埋め込みメディアを保持 | ラッパー税、ノイズによる注意散漫 |
| JSON | 構造化レコード、API レスポンス、関数呼び出しに渡すデータ | 中 | 項目名と値の対応が明確で、キーを使って必要な値を取り出しやすい | 散文では引用符などの記述が増え、冗長になりやすい |
| XML | Claude でのプロンプトセクション区切り (Anthropic 推奨) | 中 | プロンプト各部の境界が明確 | 開始タグと終了タグによって記述量が増える |
「この記事を要約」「この項目を抽出」「平易に書き直す」といった日常プロンプトでは Markdown を既定値にして問題ありません。
よくある質問
ChatGPT のコンテキストには Markdown と Plain text のどちらが良いですか
ソースに何らかの構造 (見出し・リスト・表・コード) があるなら Markdown を選んでください。見出しやリストなどの構造を示す必要がない文章なら、プレーンテキストでトークン数を抑えられます。見出しや表などの構造を保ちたい場合は、トークン数だけで判断せず Markdown を選んでください。
Claude への入力では Markdown と XML をどう使い分けますか
Claude は両方とも扱えます。Anthropic のプロンプト設計ガイドは Markdown 風の見出し・リストでセクションを区切るよう推奨しつつ、プロンプト各部の境界を明示するために XML タグ (<instructions>、<context>) の併用も勧めています。本文のトークン効率では Markdown が有利で、本文は Markdown で書き、指示と本文の区切りには XML タグを使う方法があります。
構造化コンテキストには JSON や XML が良くないですか
API レスポンスや設定のように、項目名と値で整理されたデータには JSON が向きます。プロンプト内のセクション境界を明示したい場合は XML が向きます (Anthropic のドキュメントでは、XML タグでプロンプトの各部分を区切る書き方が紹介されています)。散文に見出しやリストを付けて渡す用途では、Markdown の簡潔な記法が適しています。
URL を直接 LLM 向け Markdown に変換できますか
静的ページから任意の URL を完全クライアントサイドで取得する方法はありません (CORS で弾かれます)。一旦ページをローカル保存 (Cmd/Ctrl-S) するか、DevTools からソースをコピーし、HTML を HTML to Markdown に貼り付けてください。変換自体はブラウザ内で完結します。
FormatArc の変換は本当にブラウザ内だけで動きますか
はい。HTML から Markdown への変換処理は、ブラウザ内で完結します。貼り付けた HTML はページに同梱された Turndown別タブで開きます JavaScript ライブラリでパースされ、ソースを含む外向きリクエストは送信されません。ページ自体は CDN から HTTPS で配信され、初回訪問時に標準的なアクセス解析が走る場合はありますが、貼り付けた HTML はそれらの通信には含まれません。
まとめ
本文の要約や抽出が目的なら、Markdown を基本の入力形式にするとよいでしょう。不要なタグや属性を減らし、本文を中心とした入力に整理できます。具体的な比率は元ページに依存しますが、公開ベンチマークが示す方向は一致しています。
ソース HTML に社内情報や顧客データ、未公開の文章が含まれる場合は、変換ステップ自体が重要です。HTML to Markdown はブラウザ内で動作するため、ソースが第三者のサーバーに到達しません。
Markdown を HTML に変換する場合は、Markdown to HTML と Markdown HTML 変換ガイド を利用してください。変換後の Markdown で表を整える方法は、Markdown テーブルの作り方 を参照してください。