Cuando copias el código fuente HTML de una página y lo pegas en ChatGPT, Claude o Gemini, en la entrada se incluyen también etiquetas y atributos que no son el cuerpo. Si el objetivo es resumir o extraer el cuerpo, esas etiquetas y atributos innecesarios consumen tokens y pueden dificultar que el modelo distinga qué tiene que procesar. El HTML que copiaste está lleno de contenedores div, atributos class, scripts en línea y píxeles de seguimiento, elementos innecesarios para que el modelo entienda el cuerpo. Al convertir a Markdown, eliminas las etiquetas y atributos que sobran y puedes organizar la entrada en torno al cuerpo, conservando la estructura de encabezados y listas.
Esta guía compara Markdown y HTML como formatos de entrada para un LLM con cifras medidas, enumera los casos en los que HTML sigue siendo la elección correcta y muestra un proceso de conversión que se ejecuta en el navegador y no sube tu HTML interno a un servidor de terceros.
Respuesta rápida
Para la entrada de un LLM, prefiere Markdown. En esta muestra, el recuento de tokens del Markdown fue de alrededor del 30 % del HTML (832 → 243). La reducción varía según la cantidad de etiquetas y atributos que contenga el HTML original. En evaluaciones externas se han presentado casos en los que Markdown superó a HTML en la precisión de extracción de tablas. Pega tu HTML en HTML a Markdown y copia el resultado en tu prompt. La conversión se ejecuta por completo en tu navegador: el HTML que pegas no se sube a FormatArc ni a ningún servicio de terceros.
Cómo leen los formatos los LLM
Los LLM no "ven" el HTML renderizado como lo hace un navegador. Procesan el código fuente en bruto como un flujo de tokens. Cada corchete angular, nombre de clase y estilo en línea consume tokens de la misma ventana de contexto en la que tiene que caber tu contenido real.
De esto se derivan dos consecuencias:
- Una página HTML cargada de contenedores deja menos espacio para instrucciones, ejemplos y la respuesta del asistente.
- El ruido dentro del código fuente (
class="text-base text-gray-700", atributosdata-*, fragmentos de analítica) puede distraer al modelo del contenido que se supone que debe extraer o reescribir.
Markdown codifica la misma estructura (encabezados, listas, enlaces, código) con uno o dos signos de puntuación por elemento en lugar de etiquetas de apertura y cierre. El resultado es más corto y más coherente con los patrones que los LLM ven en sus corpus de entrenamiento: los archivos README de GitHub, los sitios de documentación, las publicaciones de Stack Overflow y los hilos de foros están escritos predominantemente en Markdown.
La razón estructural por la que Markdown es más liviano es el propio modelo de etiquetas. En el HTML que realmente copias de una página (DOM serializado o salida de un CMS), la mayoría de los elementos contenedores llegan como un par de etiquetas emparejadas (<p>...</p>, <li>...</li>, <td>...</td>, <div>...</div>), de modo que el coste del marcado se paga dos veces por elemento: una para abrir y otra para cerrar. (Técnicamente, HTML permite omitir algunas de estas etiquetas de cierre, pero la serialización del DOM renderizado y los motores de plantillas las emiten de todos modos, que es lo que pegas.) El anidamiento multiplica esto: una lista dentro de una celda de tabla dentro de una fila apila etiquetas de apertura al entrar y etiquetas de cierre al salir, y cada etiqueta también puede llevar atributos class, id, style y data-* que añaden más caracteres sin aportar el significado que el modelo necesita. Markdown expresa las mismas construcciones como marcadores únicos y sin pareja, colocados una sola vez: # para un encabezado, - para un elemento de lista, | para el límite de una columna de tabla, una línea en blanco para un salto de párrafo. No hay un token de cierre que repetir ni una ranura de atributo que rellenar, así que la sobrecarga por elemento es una pequeña constante en lugar de un par contenedor que crece con los atributos y la profundidad de anidamiento. Esa diferencia es la que cuantifican las mediciones de abajo; la causa es la ausencia de duplicación de etiquetas de apertura y cierre.
Las construcciones en sí están definidas por especificaciones publicadas: la sintaxis básica (encabezados, listas, enlaces, spans de código y código delimitado, párrafos) está estandarizada en la CommonMark SpecificationSe abre en una pestaña nueva, y las extensiones de tablas, listas de tareas, tachado y autoenlaces están definidas en la GitHub Flavored Markdown SpecSe abre en una pestaña nueva. Si consultas estas especificaciones, puedes comprobar el significado de cada construcción y las diferencias entre CommonMark y GFM.
La mezcla exacta de datos de entrenamiento de cada modelo no es pública, así que no conviene exagerar este punto. Lo que sí es verificable es que Markdown se usa ampliamente en el texto técnico público, y los principales proveedores de modelos recomiendan explícitamente una estructura similar a Markdown en sus guías de prompting; por ejemplo, la documentación de prompting de Claude de Anthropic y la guía de diseño de prompts de Gemini de Google sugieren usar encabezados y listas con viñetas para separar secciones.
Eficiencia de tokens: una comparación medida
Para comparar los formatos de forma justa, escribimos un breve documento técnico sintético que explica qué es JSON. El documento contiene un encabezado h2, dos o tres párrafos, una lista con tres viñetas, un bloque de código JSON y una tabla de tres columnas. Después expresamos el mismo contenido de tres maneras: una versión HTML con el patrón de contenedores que verías en una página típica de CMS (clases estilo Tailwind y atributos aria), una versión Markdown con CommonMark más la extensión de tablas de GFMSe abre en una pestaña nueva, y una versión de texto plano sin marcado y con la tabla expresada como filas separadas por tabuladores. El texto completo de los documentos utilizados aparece abajo, y la ubicación de los archivos de reproducción y el método de ejecución se describen al final de esta sección.
Los recuentos de tokens provienen de la biblioteca oficial de OpenAI tiktokenSe abre en una pestaña nueva, versión 0.13.0. cl100k_base es el tokenizador de la familia GPT-3.5 / GPT-4; o200k_base lo usa la familia GPT-4o.
| Formato | Caracteres (UTF-8) | Bytes | Tokens cl100k_base | Tokens o200k_base |
|---|---|---|---|---|
| HTML (DOM renderizado con clases y aria) | 2.911 | 2.911 | 832 | 835 |
| Markdown (GFM) | 1.071 | 1.071 | 243 | 247 |
| Texto plano (etiquetas eliminadas) | 986 | 986 | 213 | 217 |
Reducción frente a HTML: Markdown −63,2 % de caracteres, −70,8 % de tokens cl100k, −70,4 % de tokens o200k; texto plano −66,1 % de caracteres, −74,4 % de tokens cl100k, −74,0 % de tokens o200k. La relación caracteres-por-token resulta de 3,50 para HTML, 4,41 para Markdown y 4,63 para texto plano: el HTML cargado de símbolos (<, >, =, ", nombres de atributos) penaliza de forma medible la eficiencia del tokenizador. Los tokenizadores de Claude y Gemini difieren en sus valores absolutos, pero la dirección del impuesto por contenedores es la misma para cualquier tokenizador BPE.
Estos son valores medidos para este documento sintético concreto. En páginas web reales, la reducción varía según la cantidad de elementos que no son el cuerpo. En verificaciones externas también se reportan resultados distintos según las condiciones:
- El benchmark de Web2MDSe abre en una pestaña nueva: en un artículo de 3.000 palabras, HTML ≈ 8.000 tokens frente a Markdown ≈ 2.800 tokens (-67 %).
- El artículo de Beam.ai de 2026Se abre en una pestaña nueva: una reducción de tokens del 68 % en contenido limpio, de hasta el 87 % en páginas reales con todo el andamiaje del DOM.
- El análisis de ReleasePadSe abre en una pestaña nueva: una reducción del 10 al 20 % en listas con viñetas simples, que escala con fuerza a medida que aumenta la densidad de contenedores.
La tasa de reducción varía según las condiciones, pero en todos los casos el recuento de tokens del Markdown es menor que el del HTML. Cuando introduces varios documentos a la vez, las etiquetas y atributos innecesarios de cada documento también consumen tokens y reducen el espacio de entrada disponible para el cuerpo.
Documentos de muestra exactos
Versión HTML (2.911 caracteres / 832 tokens cl100k)
<section class="prose prose-lg max-w-none">
  <h2 class="text-2xl font-semibold mt-8 mb-4" id="what-is-json">What is JSON?</h2>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.</p>
  <p class="text-base text-gray-700 leading-relaxed mb-4">A JSON document is built from a small set of building blocks:</p>
  <ul class="list-disc pl-6 mb-4 space-y-1">
    <li class="text-base text-gray-700">Objects: unordered collections of key-value pairs wrapped in <code class="bg-gray-100 px-1 rounded">{}</code></li>
    <li class="text-base text-gray-700">Arrays: ordered lists of values wrapped in <code class="bg-gray-100 px-1 rounded">[]</code></li>
    <li class="text-base text-gray-700">Primitives: strings, numbers, booleans, and <code class="bg-gray-100 px-1 rounded">null</code></li>
  </ul>
  <p class="text-base text-gray-700 leading-relaxed mb-4">Here is a minimal example representing a single user record:</p>
  <pre class="bg-gray-900 text-gray-100 p-4 rounded overflow-x-auto mb-4"><code class="language-json">{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}</code></pre>
  <p class="text-base text-gray-700 leading-relaxed mb-4">The core value types and their typical use cases are summarized below.</p>
  <table class="w-full border-collapse mb-4" aria-label="JSON value types">
    <thead>
      <tr class="border-b border-gray-300">
        <th class="text-left p-2 font-semibold">Type</th>
        <th class="text-left p-2 font-semibold">Example</th>
        <th class="text-left p-2 font-semibold">Typical use</th>
      </tr>
    </thead>
    <tbody>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">string</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">"hello"</code></td>
        <td class="p-2">Names, labels, free text</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">number</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">3.14</code></td>
        <td class="p-2">IDs, counts, measurements</td>
      </tr>
      <tr class="border-b border-gray-200">
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">boolean</code></td>
        <td class="p-2"><code class="bg-gray-100 px-1 rounded">true</code></td>
        <td class="p-2">Flags, feature toggles</td>
      </tr>
    </tbody>
  </table>
  <p class="text-base text-gray-700 leading-relaxed mb-4">JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.</p>
</section>
Versión Markdown / CommonMark + GFM (1.071 caracteres / 243 tokens cl100k)
## What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

- Objects: unordered collections of key-value pairs wrapped in `{}`
- Arrays: ordered lists of values wrapped in `[]`
- Primitives: strings, numbers, booleans, and `null`

Here is a minimal example representing a single user record:

```json
{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}
```

The core value types and their typical use cases are summarized below.

| Type | Example | Typical use |
| --- | --- | --- |
| string | `"hello"` | Names, labels, free text |
| number | `3.14` | IDs, counts, measurements |
| boolean | `true` | Flags, feature toggles |

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
Versión de texto plano (986 caracteres / 213 tokens cl100k)
What is JSON?

JSON (JavaScript Object Notation) is a lightweight, text-based data format used to exchange structured data between systems. It originated in JavaScript but is now language-independent and supported by virtually every modern programming language.

A JSON document is built from a small set of building blocks:

Objects: unordered collections of key-value pairs wrapped in {}
Arrays: ordered lists of values wrapped in []
Primitives: strings, numbers, booleans, and null

Here is a minimal example representing a single user record:

{
  "id": 42,
  "name": "Ada Lovelace",
  "active": true
}

The core value types and their typical use cases are summarized below.

Type	Example	Typical use
string	"hello"	Names, labels, free text
number	3.14	IDs, counts, measurements
boolean	true	Flags, feature toggles

JSON is widely used for REST API payloads, configuration files, and persisting application state because it is easy to read, easy to parse, and supported everywhere.
Los tres archivos fuente, el script de medición basado en tiktoken de OpenAI (measure.py) y el JSON de resultados están comprometidos en el repositorio bajo scripts/benchmarks/markdown-vs-html-for-llms/. Ejecuta python3 -m venv venv && ./venv/bin/pip install tiktoken==0.13.0 && ./venv/bin/python measure.py y reproducirás exactamente los números de la tabla anterior.
Privacidad: mantén el HTML sensible fuera de los servicios de terceros
Los argumentos sobre tokens y precisión están muy trillados en otros artículos. El ángulo que la mayoría omite es qué pasa con el HTML de origen durante el paso de conversión.
Muchos conversores en línea de "HTML a Markdown" ejecutan la conversión en un servidor backend. Pegas tu HTML, la página lo envía por POST a una API y el servidor devuelve Markdown. Eso está bien para un fragmento público de Wikipedia. No está bien para:
- Una página de documentación interna exportada desde Confluence o Notion.
- El volcado de HTML de un panel de administración que contiene nombres de clientes.
- El cuerpo de la respuesta de un sitio de staging antes de que se apruebe el texto de marketing.
- El cuerpo de cualquier correo electrónico en HTML con datos personales.
La herramienta HTML a Markdown de FormatArc es una página estática. La conversión a Markdown está implementada en JavaScript que se ejecuta en tu navegador, usando la biblioteca TurndownSe abre en una pestaña nueva incluida en la página. El HTML que pegas se analiza localmente; ninguna solicitud de red lleva el HTML de origen a FormatArc ni a ningún servicio de terceros. Puedes verificarlo tú mismo abriendo la pestaña de red de las herramientas de desarrollo del navegador, pegando una cadena identificable de forma única en el panel de HTML, pulsando Run y confirmando que ninguna solicitud saliente contiene tu cadena.
"En el navegador" significa aquí que el HTML de origen no se sube. La página en sí se sigue sirviendo por HTTPS desde una CDN, y es posible que se cargue analítica estándar una vez en la primera visita, pero el documento que conviertes nunca sale de tu equipo.
Calidad de comprensión: tablas, código y listas
El recuento de tokens es la mitad fácil. La calidad de comprensión es la mitad que decide si tu prompt realmente funciona.
Presentamos los resultados de evaluación sobre la extracción de tablas y las características de notación al introducir código o listas:
- Extracción de tablas: tal como cita el análisis de ReleasePadSe abre en una pestaña nueva, una evaluación basada en GPT que se referencia con frecuencia informa una precisión de ~60,7 % en tablas Markdown frente a ~53,6 % en tablas HTML equivalentes, una brecha de 7 puntos sobre datos subyacentes idénticos.
- Manejo de bloques de código: el código delimitado de Markdown con una indicación de lenguaje (
```python) preserva la señal del lenguaje de forma limpia; el HTML suele anidar la indicación de lenguaje dentro de un atributo de clase (<pre><code class="language-python">), que el modelo tiene que extraer del marcado. - Listas anidadas: la indentación de Markdown ofrece una fuerte pista estructural con bajo coste de tokens. Las cadenas
<ul><li><ul><li>de HTML consumen tokens y, en ocasiones, confunden al modelo sobre a qué lista pertenece un elemento hijo.
Nada de esto significa que Markdown sea universalmente más preciso (consulta en la siguiente sección dónde gana HTML). Al menos en la extracción de tablas, además de la reducción de tokens con Markdown, también se presentan resultados de evaluación que muestran una mejora de la precisión.
Dónde HTML sigue siendo la elección correcta
Markdown no siempre es la respuesta. Hay tres escenarios en los que pegar HTML es genuinamente mejor:
Cuando la semántica vive en los atributos
aria-label, role, itemprop, los microdatos y las etiquetas de Open Graph transmiten información que no tiene equivalente en Markdown. Si le pides al modelo que audite la accesibilidad, extraiga metadatos estructurados de productos o verifique el marcado de schema.org, los atributos HTML son el contenido. Eliminarlos con un conversor de Markdown destruye la tarea.
Cuando necesitas el diseño visual, no solo el texto
Los diagramas SVG, los gráficos incrustados, los widgets <iframe> y los atributos de datos personalizados de componentes interactivos sobreviven en HTML y desaparecen en Markdown. En mayo de 2026, Thariq Shihipar de Anthropic publicó Using Claude Code: The Unreasonable Effectiveness of HTMLSe abre en una pestaña nueva, argumentando que, para los agentes de IA que producen una salida rica orientada a las personas, el rango expresivo de HTML (diseños con estilo, elementos interactivos, SVG incrustado) vale su mayor coste en tokens. En el lado de la entrada, piensa si el diseño o los elementos incrustados son en sí mismos objeto de análisis. Si necesitas conservar esa información, HTML es una buena opción.
Cuando el modelo va a renderizar el resultado
En usos en los que modificas HTML existente y el resultado también se muestra directamente en el navegador, a veces puedes simplificar la configuración de herramientas manteniendo HTML desde la entrada hasta la salida. No obstante, no es necesario decidir el formato de entrada solo por el formato de salida final; elige según la información que quieras conservar en la entrada y la configuración del proceso de conversión.
Un flujo de trabajo práctico: de HTML a Markdown listo para un LLM
Para el caso común (tienes una página web o un correo electrónico en HTML y quieres darle a un LLM el contenido sin el impuesto del marcado) aquí tienes el flujo de trabajo. La conversión de HTML a Markdown se realiza en el navegador. Si envías el texto convertido a un LLM externo, comprueba aparte si puede incluir información confidencial.
Paso 1: obtén el HTML
En Chrome o Firefox, haz clic derecho en la página y elige "Ver código fuente de la página", o usa el panel de elementos de las herramientas de desarrollo y copia el HTML externo del elemento <article> o <main>. Para un correo en HTML, usa "Ver código fuente" en tu cliente de correo.
Si solo necesitas el cuerpo del artículo, copia ese subárbol en lugar de la página entera. Eliminar la navegación, la barra lateral y el pie de página en esta etapa evita convertir contenido innecesario y también reduce los tokens que pasas al LLM. Si copias la página completa y acabas con <span> y estilos en línea dentro del pegado, en Pegar HTML como Markdown explicamos qué quitar y en qué orden.
Paso 2: convierte en tu navegador
Pega en HTML a Markdown y pulsa Run. El Markdown aparece en el panel derecho.
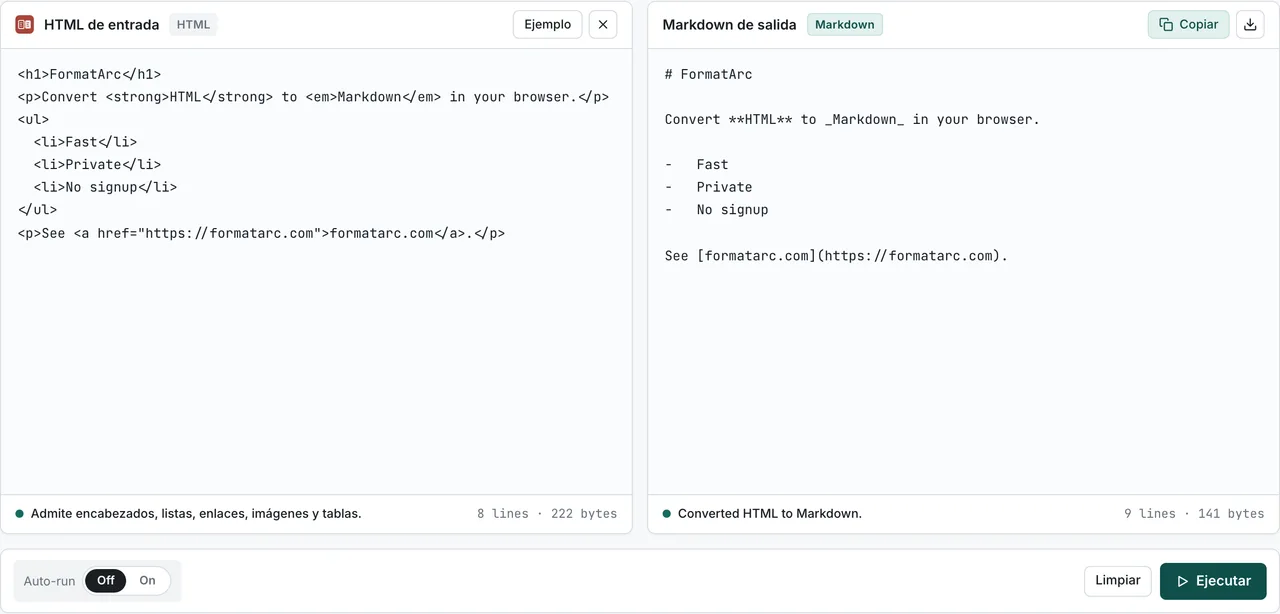
Para un recorrido más detallado de la conversión en sí (tablas, rutas de imágenes, casos límite de colspan) consulta la guía de HTML a Markdown. Para la dirección inversa, cuando el LLM responde con Markdown que quieres recuperar como HTML, Markdown a HTML también lo procesa en local.
Paso 3: recorta antes de pegar
Incluso después de la conversión, revisa el Markdown en busca de residuos que no necesitas:
- Enlaces de navegación que se convirtieron en elementos de lista en la parte superior.
- Banners de consentimiento de cookies que aún dejaron un párrafo detrás.
- Bloques de copyright del pie de página.
Si eliminas los enlaces y textos de aviso innecesarios después de la conversión, aumentas el espacio de entrada disponible para el cuerpo.
Paso 4: redacta el prompt con el Markdown limpio
Una plantilla sencilla que funciona para la mayoría de las tareas de extracción:
Below is a documentation page in Markdown.

Task: <one sentence>.
Constraints: <output format, length, etc.>.

---

<paste the cleaned Markdown here>
Los encabezados de Markdown le dan al modelo anclas sólidas a las que referirse en su respuesta ("En la sección 'Sintaxis'..."), lo que mejora la especificidad de la respuesta.
Errores frecuentes al convertir HTML para la entrada de un LLM
Cinco cosas suelen salir mal. Presta atención a estas:
- Los bloques de código pierden su indicación de lenguaje.
<pre><code class="language-python">debería convertirse en```python. Algunos conversores descartan la indicación, lo que obliga al modelo a adivinar el lenguaje. - Las tablas con
colspanorowspanse colapsan. Las tablas de GFM no pueden representar la combinación de celdas, así que la estructura de la tabla original puede perderse tras la conversión. Cuando puedas reorganizar las celdas combinadas en filas y columnas normales, también existe la opción de convertir a través de CSV a Markdown. La guía de CSV a Markdown recorre la conversión. Consulta también la chuleta de sintaxis de tablas Markdown y la chuleta de tablas GFM para la alineación y el escape. - HTML en línea que se cuela. Tanto CommonMark como GFM permiten HTML en bruto en línea. Si el modelo va a ver
<span class="text-red">important</span>en tu "Markdown", eso vuelve al cubo del impuesto por contenedores. Usa un conversor que emita Markdown puro en los casos que pueda, y reserva el HTML en bruto solo para las construcciones (notación matemática, tablas complejas) que realmente lo necesiten. - Presta atención a las rutas relativas de imágenes y enlaces. Por ejemplo,
<img src="/images/foo.png">se convierte en, pero el LLM no puede obtener esa ruta. Cuando necesites indicar el destino, reescribe tanto las imágenes como los enlaces a URL absolutas. Si no quieres que el modelo consulte las imágenes, indícalo explícitamente en el prompt. - Diferencia entre CommonMark y GFM. Las tablas, las listas de tareas, el tachado y los autoenlaces son extensiones de GFM. Si vas a mostrar el Markdown convertido con otra herramienta, comprueba también si esa herramienta admite GFM. Consulta CommonMark vs GFM para conocer las diferencias de sintaxis admitidas.
Comparación de formatos de un vistazo
Para los impacientes, aquí está la matriz de decisión:
| Formato | Cuándo usarlo como entrada de un LLM | Coste en tokens | Punto fuerte | Punto débil |
|---|---|---|---|---|
| Markdown | Opción por defecto para la mayoría de los prompts: documentación, artículos, READMEs, registros de chat | Bajo | Señales estructurales cercanas a los datos de entrenamiento; conserva tablas, listas y código | Pierde la semántica de los atributos y los estilos en línea |
| Texto plano | Extracción de texto pura, tareas tipo OCR | El más bajo | El más ligero | Se pierde la estructura; poco adecuado para listas o tablas |
| HTML | Auditorías de accesibilidad, schema.org / microdatos, análisis del diseño visual | El más alto | Conserva atributos, semántica y contenido multimedia incrustado | Impuesto de contenedores; el ruido distrae al modelo |
| JSON | Registros estructurados, respuestas de API, payloads de llamadas a funciones | Medio | Esquema sin ambigüedad; el modelo reconoce las claves con facilidad | Verboso para prosa; sobrecarga de comillas |
| XML | Anthropic recomienda etiquetas XML para las secciones del prompt en Claude | Medio | Límites explícitos entre las partes del prompt | Las etiquetas de apertura y cierre aumentan la cantidad de texto |
Para la mayoría de los prompts cotidianos ("resume este artículo", "extrae estos campos", "reescribe en lenguaje sencillo") Markdown es la opción correcta por defecto.
Preguntas frecuentes
¿Debería usar Markdown o texto plano para el contexto de ChatGPT?
Elige Markdown si la fuente tiene alguna estructura (encabezados, listas, tablas, código). Si es un texto que no necesita mostrar estructuras como encabezados o listas, puedes limitar el recuento de tokens con texto plano. Si quieres conservar estructuras como encabezados o tablas, elige Markdown sin decidir solo por el recuento de tokens.
¿Cómo uso Markdown y XML para la entrada de Claude?
Claude maneja ambos. La guía de prompting de Anthropic recomienda encabezados y listas al estilo Markdown para separar las secciones del prompt, y además fomenta el uso de etiquetas XML (<instructions>, <context>) como límites entre las partes del prompt. Markdown sigue ganando en eficiencia de tokens para el contenido en sí; una opción es escribir el cuerpo en Markdown y usar etiquetas XML para separar las instrucciones del cuerpo.
¿Y JSON o XML para el contexto estructurado?
Usa JSON cuando los datos sean naturalmente tabulares o con forma de registros (respuestas de API, configuración). Usa XML cuando quieras límites explícitos entre las secciones del prompt; la documentación de Anthropic usa este estilo. Cuando entregas prosa con encabezados o listas, la notación concisa de Markdown es adecuada.
¿Cómo convierto una URL directamente a Markdown listo para un LLM?
No existe una forma totalmente del lado del cliente para obtener una URL arbitraria desde una página estática (CORS lo bloquea). Guarda la página localmente primero (Cmd/Ctrl-S, o copia el código fuente desde las herramientas de desarrollo) y pega el HTML en HTML a Markdown. La conversión en sí se mantiene en tu navegador.
¿La conversión de FormatArc es realmente solo en el navegador?
Sí, para el paso de conversión. El HTML que pegas lo analiza la biblioteca JavaScript TurndownSe abre en una pestaña nueva incluida en la página, y no se envía ninguna solicitud que contenga la fuente. La página en sí se carga desde una CDN por HTTPS y puede hacer llamadas de analítica estándar en la primera visita, pero el HTML que pegaste no forma parte de ninguna solicitud saliente.
Para terminar
Si el objetivo es resumir o extraer el cuerpo, es buena idea usar Markdown como formato de entrada básico. Puedes reducir las etiquetas y atributos innecesarios y organizar la entrada en torno al cuerpo. La proporción exacta depende de la página de origen, pero la dirección es coherente en todos los benchmarks publicados.
Si el HTML de origen es sensible (documentos internos, datos de clientes, borradores no publicados) el paso de conversión en sí importa. HTML a Markdown se ejecuta localmente en tu navegador, así que la fuente nunca llega a un servidor de terceros.
Para la dirección inversa, consulta Markdown a HTML y la guía de Markdown a HTML. Para problemas específicos con las tablas de tu Markdown convertido, la chuleta de sintaxis de tablas Markdown cubre el escape, la alineación y los errores comunes.