经营开发博客久了,总会遇到平台搬家或备份既有文章的状况。Medium、Dev.to、Hashnode,再加上日本开发者生态主流的 Qiita 与 Zenn,写文章时大多支持 Markdown,但真正要离开平台时(导出),各家提供的数据格式却不尽相同:有的把 Markdown 原稿原封不动还给你,有的用 JSON 打包导出,Medium 则只提供装了 HTML 文件的 ZIP 压缩包。
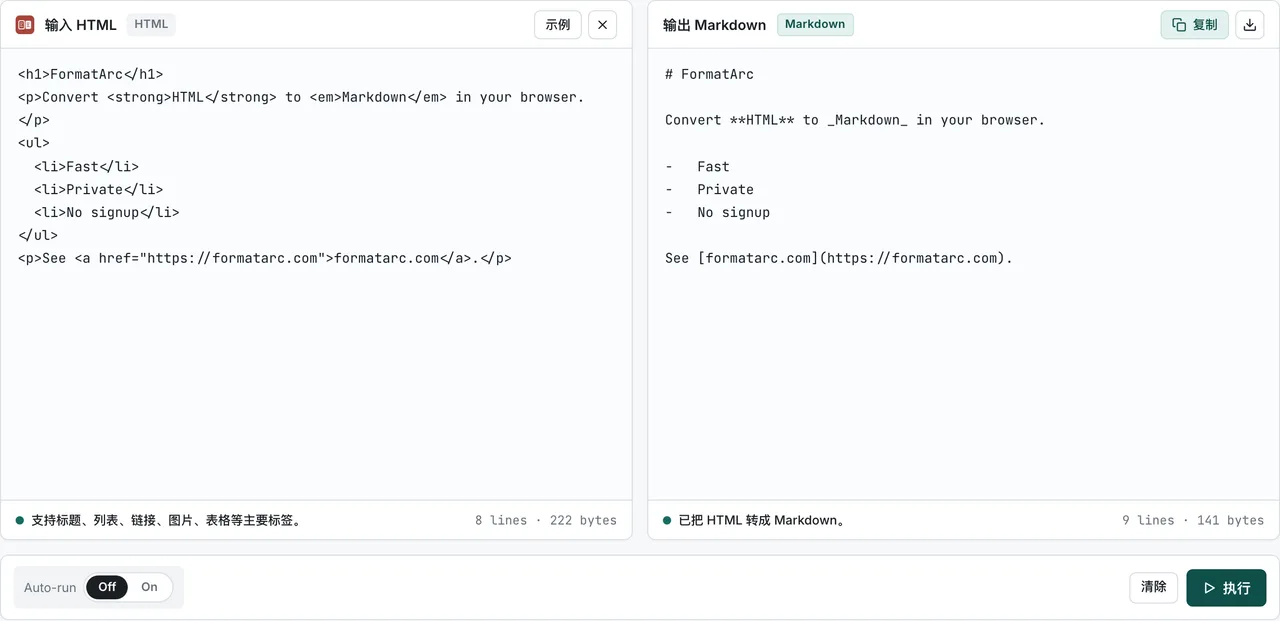
本文将整理各平台的文章提取方式与数据格式差异、frontmatter 重建、Qiita 到 Zenn 的四步搬家流程,以及只剩 HTML 时如何还原成 Markdown。如果你手上只剩公开页面的 HTML,可以把它粘贴到 HTML 转 Markdown 里,在浏览器中直接还原成 Markdown,转换全程不经过外部服务器。
各平台文章提取方式与数据格式比较
每个平台的导出功能所提供的数据格式都不同。规划搬家或备份时,可以参考下面这张格式对照表。
| 平台 | 文章提取方式 | 提供的数据格式 |
|---|---|---|
| Dev.to | 通过 编辑器指南在新标签页中打开 中记载的 API 获取,或善用 社区导出工具在新标签页中打开 | Markdown + frontmatter |
| Hashnode | 控制台批量导出为 JSON;单篇文章可在 URL 末尾加 .md 获取 Markdown 原稿(官方变更记录在新标签页中打开) | JSON / Markdown |
| Medium | 通过「Download your information」下载包含 posts/ 文件夹的 ZIP | HTML(无 Markdown 导出选项) |
| Qiita(日本) | 通过 API v2在新标签页中打开 获取每篇文章的 Markdown(body)与 HTML(rendered_body) | Markdown + HTML |
| Zenn(日本) | 通过 关联的 GitHub 仓库在新标签页中打开 以本地 Markdown 文件管理 | Markdown |
搬家的起点不是「要去哪里」,而是「手上有什么格式的数据」。
- 手上是 Markdown 文件:直接进入语法差异检查与 frontmatter 重构步骤。
- 手上是 JSON 文件:从 JSON 对象中抽出 Markdown 字段(可善用社区工具把 Hashnode 导出的 JSON 拆分成
.md文件)。 - 手上是 HTML 文件:必须先转换成 Markdown。Medium 与过去网页备份就属于这种情况。
从 Dev.to、Hashnode、Medium 提取文章
从 Dev.to 获取文章
Dev.to 的编辑器本身就是纯 Markdown 基底,是搬家最轻松的平台之一。每篇贴文都带有 Jekyll 风格的 frontmatter,包含 title、published、tags、canonical_url、cover_image、series 等字段(Dev.to 编辑器指南在新标签页中打开)。在设置页面签发 API 密钥后,调用 API 端点即可获取包含 Markdown 原稿的文章列表;利用 Dev.to-exporter在新标签页中打开 这类社区脚本,一条命令就能把所有文章以 .md 文件保存在本地。
从 Hashnode 获取文章
Hashnode 提供两条路径:
- 控制台的备份导出功能会把所有文章下载为单一 JSON 文件。可用 hashnode-export-to-markdown在新标签页中打开 这类工具把 JSON 拆分回带 frontmatter 的个别 Markdown 文件。
- 2026 年 6 月起,在单篇文章 URL 末尾加上
.md,或用Accept: text/markdown标头请求,就能直接看到原始 Markdown(官方变更记录在新标签页中打开)。要快速搬几篇文章时很方便。
反过来说,如果想把外来的 Markdown 文件导入 Hashnode,可以通过控制台的 批量 Markdown 导入在新标签页中打开 功能,以 ZIP 文件一次登记。
从 Medium 获取文章
Medium 导出时不提供 Markdown。在账号设置的「Download your information」中下载的 ZIP 文件,posts/ 文件夹里每篇文章对应一个 HTML 文件。转为 Markdown 有两种方式:
- 用
mediumexporter或medium-2-md等 CLI 工具批量转换 - 数量不多的话,直接把 HTML 内容复制粘贴到 HTML 转 Markdown 中
转换在浏览器内完成,未公开的草稿或尚未发布的文章,也不必担心数据外泄到外部服务器。线上转换工具使用前该做的隐私检查,详见 线上安全:转换工具使用前必做的 5 项隐私检查(2025 年外泄事件)。如果要把 Notion 的 HTML 导出整理成 Markdown,做法相同,步骤整理在 Notion 导出 Markdown 整理。
Qiita 到 Zenn(及标准 GFM)的四步搬家
Qiita 与 Zenn 是日本技术博客生态的代表,两者的搬家(或把 Qiita 文章移到 GitHub 基底的博客)是一套典型的四步模型:
- 通过 API 提取原始文章数据
- 把平台特有语法转换为目标语法
- 组建 frontmatter 并保留发布日期(
published_at) - 图片与代码块后处理
步骤一:通过 API 提取原始文章
Qiita 提供官方 API v2在新标签页中打开,可以批量获取包含 Markdown 原稿的文章数据。在设置中签发个人访问令牌,放入请求头中,调用已认证用户的文章列表端点。
curl -H "Authorization: Bearer YOUR_TOKEN" \
  "https://qiita.com/api/v2/authenticated_user/items?page=1&per_page=100" > items.json
提取时需要确认的三件事(以官方文档在新标签页中打开为准):
- 响应中的
body字段是 Markdown 原稿,rendered_body是渲染后的 HTML。搬家时使用body。 per_page上限为 100。超过 100 篇时需递增page编号反复调用。- API 调用限制:认证时每小时 1,000 次,未认证时每个 IP 每小时 60 次。个人博客搬家绰绰有余。
如果不想敲命令,zenn-importer在新标签页中打开 这类社区工具能自动完成提取与 frontmatter 转换,但语法差异和图片后处理仍然需要手动检查。用它之前先确认工具还在维护。
步骤二:平台特有语法转换与兼容性检查
基础的 Markdown 语法(标题、列表、链接、表格)是兼容的,但各平台的容器语法或扩展语法需要改写。主要对照如下(以 Qiita 语法速查表在新标签页中打开 与 Zenn Markdown 指南在新标签页中打开 为准)。
| 元素 | Qiita 语法 | Zenn 语法 |
|---|---|---|
| 提示框 | :::note info | :::message |
| 警示框 | :::note warn / :::note alert | :::message alert |
| 折叠/展开 | <details><summary> 标签 | :::details 标题 |
| 代码块文件名 | ```ruby:qiita.rb | 支持相同语法 |
| 公式块 | ```math | $$(前后需空行) |
| 行内公式 | $`公式`$ | $公式$ |
要注意的是,Qiita 的提示框有 info、warn、alert 三种,Zenn 只有默认消息与 alert 两种,并非完美的一对一对应。因此要先决定 warn 框归入一般强调(:::message)还是注意唤起(:::message alert),再统一替换。
语法差异若不想逐一手动比对,可以将本文粘贴到 Qiita / Zenn 兼容性检查器,与 74 条语法差异规则进行对照。其中一对一决定的 37 条会立即转换,需要判断的 14 条可指定替换方式,不支持的 23 条则以提示方式告知。所有处理都在浏览器内完成。
特别需要注意的是 Zenn 不会渲染本文中的 raw HTML。Qiita 支持的 <details> 标签或 <img width="..."> 标签在 Zenn 上不会产生语法错误,而是原样以标签字符串显示在本文。同样道理,写入 :::message warn 这类不支持的框也不会有容器产生,只会显示为一行文字。
步骤三:组建 frontmatter 与保留发布日期(published_at)
Zenn 及静态网站生成器使用文件开头的 YAML frontmatter 来管理元数据(Zenn CLI 指南在新标签页中打开)。
---
title: "文章标题"
emoji: "📘"
type: "tech"
topics: ["rails", "markdown"]
published: true
published_at: "2023-05-10 09:00"
---
将 Qiita API 响应中的 title 与 tags 对应到这里。topics 最多可指定 5 个(Zenn CLI 指南在新标签页中打开),作为文件名的 slug 有限制:英文小写、数字、连字符、下划线的组合,长度 12 至 50 字符(Zenn slug 规格在新标签页中打开)。
如果要保留过去的发布日期,就在 frontmatter 的 published_at 字段指定历史日期(格式为 YYYY-MM-DD 或 YYYY-MM-DD hh:mm,日本时间基准)。Zenn 官方指南也明确指出此字段可用于从其他平台搬家时保留发布日期。不过,发布日期一旦设置就无法再修改,所以发布前务必确认数值正确。
步骤四:图片与代码块后处理
- 图片 URL:搬家后的文章仍然引用旧平台的图片 CDN 地址,显示上没有问题。但如果原账号停权或平台政策变更,图片就会消失。长期要保留的文章,建议把图片下载到本地,重新上传到目标平台的存储空间,并替换本文中的 URL。
- 代码块:文件名指定语法(
```ruby:qiita.rb)是兼容的,但 diff 显示或特定语法标记的写法可能因平台而异(例如 Zenn 用```diff js以空格区分),建议经过渲染预览确认。
防止重复内容与 canonical URL 设置
文章搬到新平台后,原平台的文章该如何处理?通常有三种选择:保留原文并在开头加上「已搬到新博客」的提示与链接、将原文简化为摘要与新链接、或删除原文。搜索引擎面对同一内容存在于不同 URL 时,会判断不清哪边是原始版本;善加利用平台支持的 canonical URL 功能,就能避免重复内容的惩罚。
Dev.to 有 frontmatter 的 canonical_url 字段可指定原始地址(Dev.to 编辑器指南在新标签页中打开),Hashnode 在发布流程及 API 中支持原始文章 URL 设置,Medium 则在 URL 导入功能使用时自动设置 canonical 链接指向原始。
没有 Markdown 原稿的文章还原(HTML 转 Markdown)
类似 Medium 的备份文件只提供 HTML,或是过去运营的博客服务已停摆、只剩网络存档中的 HTML 页面,这种情况都有。
此时把 HTML 源码粘贴到 HTML 转 Markdown 即可转为 GFM 兼容的 Markdown。例如以下 HTML 结构:
<h2>安装与运行</h2>
<p>先执行 <code>npm install</code> 命令。</p>
经过转换器后会变成干净的 Markdown:
## 安装与运行

先执行 `npm install` 命令。
所有处理都在浏览器内部执行,未公开的内部技术文档或私有草稿数据不会残留在外部服务器上。对把敏感数据粘贴到上传型在线工具心里没底的话,可以参考 线上转换工具的安全检查。如果要把 Notion 的 HTML 导出整理成 Markdown,做法相同,步骤整理在 Notion 导出 Markdown 整理。
常见问题
平台搬家时能保留原本的发布日期吗?
取决于目标平台。Markdown 本文本身不包含日期信息,但支持 frontmatter 的平台中,部分允许指定历史日期。代表性的例子是 Zenn,通过 published_at 字段正式支持保留过去的发布日(Zenn CLI 指南在新标签页中打开)。搬家前请先在原始数据中记录发布日时。
图片一定要重新上传到新平台吗?
刚搬家完时旧的图片 URL 仍可正常显示,但如果原账号被删除或平台政策变更,图片就可能失效。长期要管理的重要技术文章,建议直接下载图片、上传到新存储空间、修改本文中的 URL。
能自动检查 Qiita 与 Zenn 之间的语法差异吗?
使用 Qiita / Zenn 兼容性检查器 即可自动对照 74 种语法差异,在浏览器中立即查看一对一转换、需选择替换、以及不支持语法的提示。
小结
- 博客搬家的本质就是数据格式的转换(Markdown、JSON、HTML)。
- 依原始格式不同,流程为:提取(API、脚本)、语法规范化、frontmatter 重构、图片与代码后处理,共四步。
- 没有 Markdown 原稿的 HTML 备份数据,可通过 HTML 转 Markdown 在浏览器中还原为干净的 Markdown。
- Qiita 与 Zenn 间的搬家,善用 Qiita / Zenn 兼容性检查器 预防语法不一致。