PDF를 마크다운(Markdown)으로 변환했을 때 표가 깨지는 현상은 변환 도구의 사용법이 잘못되었기 때문이 아닙니다. PDF라는 포맷 자체가 눈에 보이는 표를 재사용 가능한 '표 구조'로 저장하지 않는 경우가 많기 때문입니다. 이 글에서는 표 깨짐이 발생하는 내부 원리와 7개 실제 문서를 대상으로 측정한 깨짐 유형, 그리고 표가 깨졌을 때 어떻게 대처해야 하는지 구체적인 절차를 설명합니다.
PDF는 눈에 보이는 표를 '표'로 저장하지 않는 경우가 많습니다
PDF의 내부는 문서의 논리적 구조가 아니라 화면에 그리기 위한 렌더링 명령어의 나열입니다. 페이지 내용은 content stream이라는 데이터 열에 저장되며, 여기에는 "이 좌표에 이 글자를 배치하라", "여기서 저기까지 선을 그어라"와 같은 그래픽 연산자와 인자만 들어 있습니다(Adobe PDF Reference 1.7새 탭에서 열립니다의 Graphics / Text 장 참조). 표의 테두리는 선을 긋는 명령어일 뿐이고, 셀 안의 내용은 그 선 근처에 배치된 글자일 뿐입니다. 두 요소를 하나로 묶어 '표의 특정 셀'로 연결해 주는 정보는 표준 PDF에 기본적으로 포함되어 있지 않습니다.
이러한 특성은 PDF 파싱 라이브러리가 반환하는 데이터를 보아도 알 수 있습니다. 예를 들어 pdf.js의 getTextContent()가 반환하는 TextItem 객체에는 str(문자열), transform(변환 행렬), width, height, hasEOL 등의 필드만 존재하며 행 번호, 열 번호, 셀 ID 같은 정보는 전혀 없습니다(PDF.js API 문서새 탭에서 열립니다). 결국 마크다운 변환 도구는 글자의 좌표와 선의 위치를 바탕으로 표의 구조를 '추정'할 수밖에 없습니다.
예외는 있습니다. 웹 접근성 등을 위해 구조 태그가 지정된 PDF(Tagged PDF)는 Table, TR, TH, TD와 같은 구조 요소를 명시적으로 가질 수 있습니다. 병합 셀에도 RowSpan, ColSpan 속성이 지정됩니다(W3C 기술 문서 PDF6: Using table elements for table markup in PDF Documents새 탭에서 열립니다). 하지만 이는 PDF 제작자가 의도적으로 태그를 부여했을 때만 해당하며, 일반적인 PDF에 이 태그가 들어 있다는 보장은 없습니다. 태그가 없다면 변환기는 다시 좌표 기반의 추정에 의존하게 됩니다.
7개 문서를 2개 방식으로 변환한 실측 결과
좌표 추정이 빗나갈 때 어떤 일이 발생하는지 실제 PDF 문서로 측정해 보았습니다. 학술 논문, 정부 기술 문서, 기입 양식, 통계표, 슬라이드, 중앙은행 보고서 등 서로 다른 성격을 가진 7개 문서를 준비해 성격이 다른 2개 계열의 변환 파이프라인에 통과시켰습니다.
- 텍스트 추출 계열: pdf.js(pdfjs-dist 6.2.108) + pdf2md(@opendocsg/pdf2md 0.2.7). 표를 조립하는 처리 단계가 없습니다.
- 구조 추정 계열: pdf-inspector(@firecrawl/pdf-inspector-wasm 0.1.3). 사각형 테두리와 폰트, 좌표를 분석해 표 구조를 추정합니다.
측정일은 2026-08-02이며 실행 환경은 Apple M5 Pro / macOS(Darwin 25.5.0) / Node v26.3.1입니다. 대상 7개 문서는 모두 텍스트 레이어를 가진 PDF이며 스캔된 이미지 PDF는 포함하지 않았습니다. 샘플 취득 스크립트와 측정 스크립트, 원본 결과 데이터는 본 사이트 저장소의 scripts/benchmarks/pdf-table-extraction/에 있습니다.
| PDF 문서 | 종류 | 텍스트 추출계 표 행 수 | 구조 추정계 표 행 수 | 텍스트 추출계 헤딩 수 | 구조 추정계 헤딩 수 |
|---|---|---|---|---|---|
| Attention Is All You Need | 2단 학술 논문 | 0 | 50 | 45 | 38 |
| BERT | 2단 학술 논문 | 0 | 106 | 27 | 42 |
| NIST Cybersecurity Framework 2.0 | 도판이 많은 기술 문서 | 0 | 45 | 3 | 27 |
| IRS Form 1040 (2025) | 기입 양식 | 0 | 42 | 24 | 5 |
| 노동력조사연보 기본집계 | 다단 통계표 | 0 | 405 | 1360 | 6 |
| 레이와 7년판 정보통신백서 개요 | 도판 중심 슬라이드 | 0 | 9 | 38 | 112 |
| 경제·물가 정세 전망 (일본은행) | 다단 중앙은행 보고서 | 0 | 19 | 211 | 1 |
이 측정 결과에서 알 수 있듯이 두 계열의 깨짐 방식은 정반대로 나타납니다. 텍스트 추출 계열은 7개 문서 모두에서 표 행 수가 0이었으며, 즉 표를 전혀 생성하지 못했습니다. 반면 구조 추정 계열은 항상 표를 만들어 내지만, 생성된 행 수가 많다고 해서 올바르게 추출되었음을 의미하지는 않습니다.
단순히 행 수만 보고 성공 여부를 판단할 수 없는 구체적인 예가 있습니다. 다단 레이아웃의 중앙은행 보고서는 제목과 본문 문장이 전부 표의 셀 안으로 잘못 들어가는 형태로 크게 깨졌지만, 전체 출력에서 표 행이 차지하는 비율은 0.43에 달했습니다. 한편 진짜 표가 포함된 세무 기입 양식의 표 행 비율은 0.45였습니다. 이 두 수치는 단순 임계값으로 구별할 수 없습니다. 즉 표로 출력된 행이 많다는 사실이 표 추출의 정확성을 보장하지 않습니다.
깨짐 유형 1 — 표가 사라지고 일반 본문만 나열됨
첫 번째 깨짐 유형은 표가 표 형태로 전혀 나오지 않는 경우입니다. 셀 안의 텍스트 자체는 추출되지만 행과 열의 구분이 완전히 사라져 숫자와 항목 이름이 일반 문장처럼 이어져 출력됩니다. 실측에서 텍스트 추출 계열 파이프라인이 이 방식으로 동작하여 7개 문서 모두에서 표 행 수가 0이었습니다.
이 깨짐 방식에는 한 가지 장점이 있습니다. 읽는 즉시 결과가 깨졌음을 바로 알아챌 수 있다는 점입니다. "표가 있어야 할 위치에 표가 없다"는 사실은 쉽게 눈에 띄기 때문에, 사용자가 원본 문서를 확인하고 수작업으로 대응하기 쉽습니다.
하지만 부작용도 있습니다. 표 안의 각 행이 마크다운 헤딩(#, ## 등)으로 잘못 승격되는 현상입니다. 실측에서 다단 통계표를 텍스트 추출계로 변환했을 때 헤딩이 무려 1360개나 생성되었습니다. 실제 원본 문서의 헤딩은 눈으로 세었을 때 약 4개에 불과했습니다. 변환 후 마크다운 목차가 수백 개로 비정상적으로 늘어났다면 이 부작용을 의심해야 합니다.
깨짐 유형 2 — 표 형태는 유지되나 셀 배치가 어긋남
두 번째 깨짐 유형은 마크다운 표 문법 자체는 정상적으로 갖추어져 있지만, 어떤 값이 어느 셀에 들어가야 하는지가 엉뚱하게 섞이는 현상입니다. 실측에서 구조 추정 계열이 이 유형에 해당했습니다. 다단 통계표는 405행의 표로 변환되었으나 여러 연도의 통계 수치가 하나의 셀에 한꺼번에 뭉쳐서 들어갔습니다.
|15~ 64歳 6625 5878 6678 5893 6732 5912 …|15~ 24歳 595|25~ 34歳 1168|
이 유형은 첫 번째 유형보다 훨씬 위험합니다. 파이프 기호(|)와 구분 행(---)이 올바르게 갖추어져 있기 때문에 마크다운 뷰어에서는 깔끔한 표로 렌더링되며, 그대로 보고서나 문서에 붙여넣어질 수 있습니다. 하지만 특정 수치가 옆 열로 1칸씩 밀려나 있더라도 원본 문서를 대조해 보지 않은 독자는 오류를 알아채기 어렵습니다. 겉보기에 깨져 보이지 않으면서 실제로는 심각하게 왜곡되어 있다는 점에서 첫 번째 깨짐보다 더 큰 주의가 필요합니다.
그림이나 다단 본문이 표로 잘못 인식되는 사례
구조 추정 방식은 표가 아닌 요소를 표로 잘못 판별하기도 합니다. 실측에서 확인된 대표적인 사례 2가지를 소개합니다.
NIST Cybersecurity Framework 2.0의 원형 다이어그램(Fig. 1 CSF Core structure)의 경우, 그림 원형을 따라 배치된 텍스트가 표의 셀로 인식되었습니다. 게다가 첫 글자가 떨어져 나가는 현상이 발생했습니다.
| Fig. 1. CSF Core structure |||
| --- | --- | --- |
| DENTIFY | ROTECT | ETECT ESPOND |
올바른 단어는 IDENTIFY, PROTECT, DETECT, RESPOND입니다. 원형 테두리를 따라 곡선 배치된 텍스트가 조각나고 앞 글자가 별도 요소로 처리되면서 의미를 알 수 없는 단어로 바뀌었습니다.
또 다른 사례는 문서 전체가 하나의 거대한 표로 변환된 경우입니다. 다단 레이아웃의 중앙은행 보고서에서는 제목과 본문 문단 전체가 표의 셀 안으로 들어갔습니다.
|||||2025 年5月1日|
| --- | --- | --- | --- | --- |
||【基本的見解】|1|経済・物価情勢の展望(2025 年4月) <概要>|日本銀行|
이 문서에서 구조 추정계가 생성한 헤딩은 문서 끝의 '이상(以 上)' 단 1개뿐이었습니다. 페이지의 다단 본문 레이아웃 전체가 여러 열을 가진 하나의 거대한 표로 해석되었기 때문입니다.
변환 방식을 바꾸어 해결되는 깨짐과 해결되지 않는 깨짐
변환 도구나 방식을 바꿀 가치가 있는지 여부는 깨짐의 근본 원인에 따라 달라집니다.
| 증상 | 발생 원인 | 다음 대처 방법 |
|---|---|---|
| 표가 하나도 나오지 않음 | 사용한 도구가 표 조립 처리를 지원하지 않음 | 표 구조 추정 기능이 있는 도구를 사용해 볼 가치가 있음 |
| 표 형태는 나오나 셀이 어긋남 | 좌표 기반 추정이 빗나감 | 다른 도구로 바꿔도 비슷하게 어긋날 가능성이 높음. 원본과 대조해 수작업으로 수정 |
| 다이어그램의 글자가 표로 나옴 | 그림 속 텍스트가 표 셀로 오인됨 | 해당 표는 삭제하고 원본 PDF의 그림을 참조 |
| 본문 전체가 하나의 표가 됨 | 다단 레이아웃이 표로 해석됨 | 텍스트만 추출하는 방식으로 전환 |
| 글자가 한 글자도 추출되지 않음 | 텍스트 정보가 없는 이미지 PDF | 변환으로 해결 불가. OCR(문자 인식) 필요 |
일반적인 경향으로 "표가 나오느냐 안 나오느냐"는 변환 방식을 바꾸면 달라집니다. 그러나 "생성된 표가 정확한가"는 원본 PDF 자체에 태그 구조 정보가 없다면 어떤 방식을 써도 추정에 불과하므로, 도구를 바꾼다고 해서 정확성을 보장받을 수는 없습니다.
보유한 PDF가 어떤 방식으로 변환되는지 확인하는 가장 확실한 방법은 직접 변환해 보는 것입니다. PDF to Markdown 변환기는 브라우저 내부에서만 변환 처리를 수행하므로 외부 서버로 파일을 전송하지 않고 안전하게 결과를 테스트할 수 있습니다.
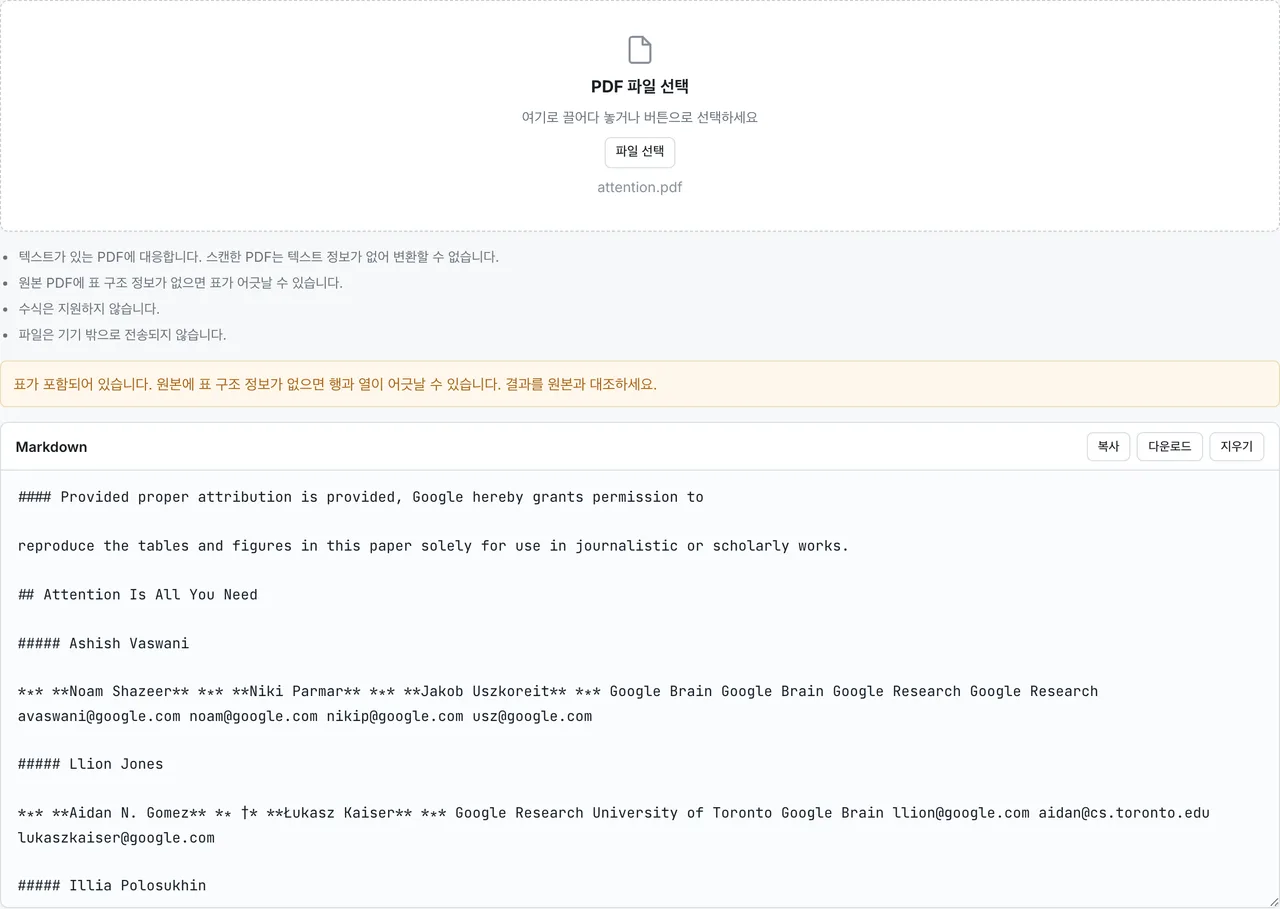
깨진 표를 바로잡는 방법
변환 결과는 반드시 원본과 대조하기
표를 포함한 PDF를 마크다운으로 변환했다면 결과를 그대로 사용하지 말고 반드시 원본 PDF와 일대일로 대조해야 합니다. 특히 셀 위치가 어긋나는 깨짐 유형 2는 눈으로 보아서는 알아챌 수 없기 때문에 원본 대조가 유일한 검증 수단입니다.
대조 작업은 다음 순서로 진행하는 것이 효율적입니다.
- 행 수와 열 수가 원본과 일치하는지 확인합니다.
- 헤더 행의 항목 이름이 원본의 순서대로 나열되어 있는지 확인합니다.
- 각 행의 맨 앞 셀과 맨 끝 셀의 값을 원본과 비교합니다. 셀 밀림 현상은 대개 양 끝부분에서 먼저 드러납니다.
- 원본에 병합 셀(merged cell)이 있던 영역을 개별적으로 확인합니다. 마크다운 표는 셀 병합을 기본적으로 표현할 수 없으므로 반드시 어떤 형태로든 변형되어 있습니다.
수치 데이터 표는 다시 만드는 것이 안전함
금액, 측정치, 통계 수치처럼 한 셀의 어긋남이 데이터의 의미를 완전히 바꾸어 놓는 표는 어긋난 마크다운 표를 고치는 것보다 새로 만드는 편이 훨씬 안전하고 빠릅니다. 원본 PDF에서 표 텍스트를 복사해 스프레드시트(엑셀 등)에 붙여넣어 정렬한 뒤, CSV로 내보내어 CSV to Markdown 변환기로 변환하면 셀 간의 대응 관계를 정확하게 유지할 수 있습니다.
마크다운 표 문법(파이프 기호 배치, 구분 행, 정렬 콜론, 셀 안의 파이프 이스케이프 등)을 확인하고 싶다면 마크다운 표 작성법을 참고하세요. 마크다운 표는 순수 CommonMark 핵심 사양이 아니라 GitHub Flavored Markdown(GFM)의 확장 사양으로 정의되어 있으므로(GFM 사양 Tables extension새 탭에서 열립니다), 붙여넣을 대상 플랫폼이 GFM 표를 지원하는지도 함께 확인하는 것이 좋습니다.
깨지기 쉬운 PDF와 비교적 안전한 PDF 판별법
이 체크리스트는 절대적인 보증은 아니지만 표 깨짐 위험을 사전에 낮추기 위한 기준입니다.
변환 전에 확인할 점
- PDF 뷰어에서 표 안의 글자를 마우스로 드래그하여 선택할 수 있는지 확인합니다. 선택되지 않는다면 텍스트 레이어가 없는 이미지이므로 변환 대상이 되지 않습니다.
- 표에 명확한 테두리 선이 그어져 있는지 확인합니다. 테두리 선이 없는 표는 셀 경계를 추정하기 어렵습니다.
- 페이지 레이아웃이 1단 구성인지 확인합니다. 2단이나 3단 레이아웃은 본문 단 자체가 표로 오인될 수 있습니다.
- 표가 여러 페이지에 걸쳐 나뉘어 있지 않은지 확인합니다. 페이지를 넘어가는 표는 페이지별로 분리된 표로 출력될 가능성이 높습니다.
- 병합된 셀이 있는지 확인합니다. 마크다운 표 문법에는 셀 병합 표현이 없어 반드시 형태가 왜곡됩니다.
- 표 내부에 다이어그램이나 아이콘 이미지가 섞여 있지 않은지 확인합니다. 이미지 속 글자가 표의 셀로 잘못 끼어들 수 있습니다.
변환 후에 의심해야 할 점
- 행마다 열의 개수가 다릅니다. 이는 줄마다 셀 경계 추정이 흔들렸다는 증거입니다.
- 빈 셀이 비정상적으로 많거나, 구분 행 직전에
|||||처럼 빈 구분자만 있는 줄이 존재합니다. - 헤딩(
#)의 개수가 비정상적으로 많습니다. 표 내부 본문 행이 헤딩으로 오인되었을 가능성이 높습니다. - 실측의
DENTIFY사례처럼 앞 글자가 잘려 나가 의미를 알 수 없는 단어가 나열되어 있습니다. - 표 셀 안에 명백히 일반 본문 문단인 긴 문장이 통째로 들어가 있습니다.
스캔한 PDF는 텍스트 정보가 없어 변환할 수 없습니다
종이 문서를 스캐너나 카메라로 촬영해 만든 PDF는 페이지 전체가 1장의 이미지로 저장되어 있습니다. 사람의 눈에는 글자가 보이지만 파일 내부에는 텍스트 데이터가 존재하지 않습니다. 이 경우 표가 깨지는 문제를 논하기 전에 추출할 수 있는 글자 자체가 없습니다.
이러한 문서에 필요한 것은 단순 포맷 변환이 아니라 광학 문자 인식(OCR)입니다. FormatArc의 PDF 변환 도구는 OCR 엔진을 내장하고 있지 않으므로, 이러한 스캔 PDF는 변환할 수 없다는 안내 메시지를 표시하고 임의의 추측성 출력을 반환하지 않도록 설계되어 있습니다. 잘못된 데이터가 출력되는 것보다 변환 불가 상태를 명확히 알려 주는 것이 더 안전하기 때문입니다.
보유한 PDF가 스캔 문서인지 확인하려면 뷰어에서 글자를 드래그해 보세요. 마우스로 글자가 선택되지 않는다면 이미지입니다.
자주 묻는 질문
다른 변환 도구를 사용하면 표가 정상적으로 나오나요?
깨짐의 원인에 따라 다릅니다. 표가 아예 추출되지 않는 경우라면 구조 추정 기능이 있는 도구로 변경했을 때 표 형태를 얻을 수 있습니다. 그러나 셀 배치가 어긋나 있는 경우라면 원본 PDF에 태그 구조 정보가 없는 한 어떤 도구라도 좌표 추정에 의존하므로 해결을 보장할 수 없습니다.
Tagged PDF라면 표가 깨지지 않나요?
구조 태그가 올바르게 지정되어 있다면 Table, TR, TH, TD 구조를 파일에서 직접 읽어올 수 있으므로 추정에 의존하지 않고 정확하게 변환됩니다. 다만 태그의 존재 여부는 PDF 제작 시점의 설정에 의해 결정되며 읽는 쪽에서 선택할 수 없습니다. 또한 태그가 있더라도 실제 시각적 레이아웃과 일치하지 않는 경우도 있습니다.
스캔한 PDF도 변환할 수 있나요?
FormatArc에서는 변환할 수 없습니다. 스캔한 PDF는 텍스트 레이어가 없어 OCR 처리가 필요한데, 본 도구는 OCR을 지원하지 않으므로 변환 불가 안내를 표시합니다.
PDF에서 표만 따로 추출하는 방법이 있나요?
PDF에서 표만 별도로 잘라내는 기능은 없지만, 원본 PDF에서 표 영역을 복사하여 스프레드시트에 붙여넣은 뒤 CSV로 저장하고, 이를 마크다운으로 변환하면 셀의 대응 관계를 온전히 유지하면서 표를 가져올 수 있습니다. 수치 표를 다룰 때는 이 방법이 가장 확실합니다.
정리
PDF의 표가 마크다운 변환 시 깨지는 근본적인 이유는 PDF가 시각적인 표를 재사용 가능한 논리 구조로 보존하지 않는 경우가 많아 변환기가 글자와 선의 좌표로부터 구조를 추정해야 하기 때문입니다. 실제 7개 문서 측정 결과 표를 아예 만들지 못하는 유형과, 표 형태는 유지되지만 셀 배치가 잘못되는 유형의 2가지 깨짐이 모두 확인되었습니다. 특히 후자는 겉보기로 오류를 파악하기 어려우므로 표가 포함된 PDF를 변환한 후에는 반드시 원본과 대조해야 합니다.
보유한 PDF가 어떻게 변환되는지 확인해 보려면 PDF to Markdown 변환기에서 테스트해 보세요. 모든 파일은 브라우저 내부에서만 처리되며 외부로 전송되지 않습니다.